日期:2026年 07月 18日
標籤: Linux Ubuntu Docker Docker-Compose Container Stable Diffusion ComfyUI WSL 2 Wan 2.1 GGUF LoRA
摘要:生成式AI
應用所需:1. 已安裝 Windows 的 Docker Desktop (Use WSL 2 instead of Hyper-V)
2. 已安裝 Hyper-V + ComfyUI(容器化)
3. 顯示卡使用 RTX 5070 以上 + 12G VRAM
4. Windows 10 以上作業系統
解決問題:1. 延續前二篇文章,Wan 生成影片的速度優化方案,如何整合 LightX2V LoRA + GGUF 極致提升生成影片速度
2. 說明如何整合兩種模型 LightX2V LoRA + GGUF 到 ComfyUI
相關參考:1. 0002. ComfyUI容器化執行 Wan 2.1(2.2) 生成影片(圖片生成影片) + 頻頻跳出 Killed 錯誤? 說明隱藏在 Windowss 下 WSL2 記憶體限制裡的 OOM 隱形殺手
2. 0003. 動態與速度兼得:如何用 LightX2V LoRA 替代傳統採樣算法,解放消費級顯卡的 Wan 2.1 影片生成潛力
3. 0004. 動態與速度兼得:打破顯示卡 12GB 顯存限制!實戰 ComfyUI 導入 Wan 2.1 GGUF 量化模型提升速度保持影片品質
基本介紹:本篇分為三大部分。
第一部分:問題描述
第二部分:優化工作流-導入 LightX2V LoRA + GGUF 量化模型
第三部分:驗證成果
第一部分:問題描述
Step 1:Wan 2.1(2.2) 執行效能慢補充
若受限於顯示卡 VRAM 不足於 16G 的情況下,用一般的方式執行 Wan 2.1(2.2) 圖片生成影片效能會很差,因為 VRAM 不足的情況下會導致
不斷把資料「往系統 RAM 甚至硬碟 Swap 搬運 (Offload)」
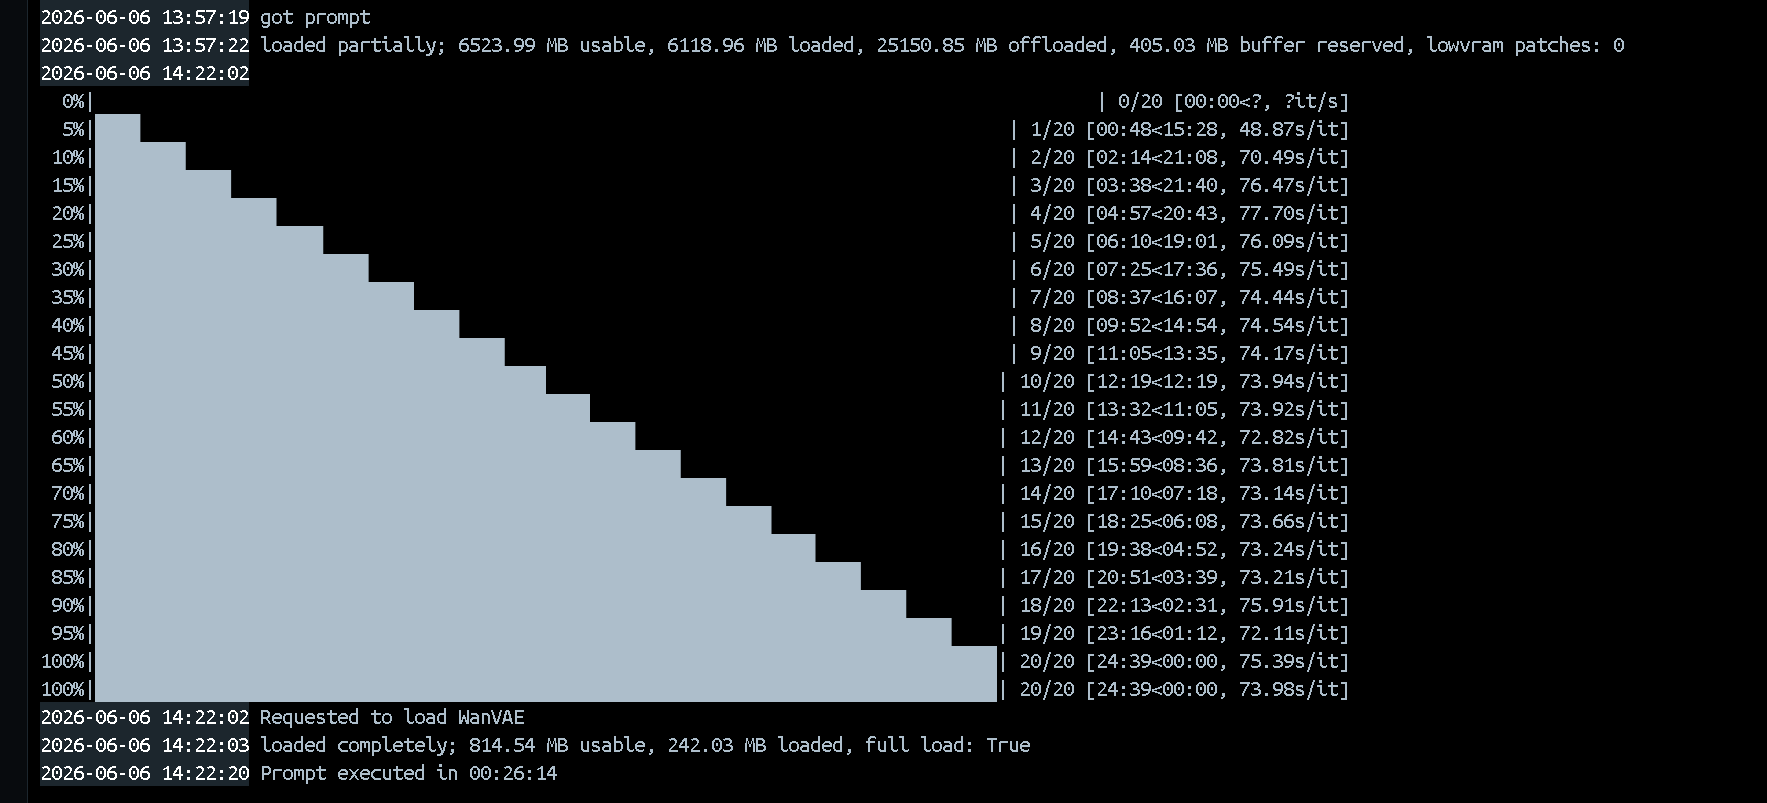
因此最初一篇文章生成 5 秒的影片,25 分鐘有很多都是在執行釋放記憶體的工作
後續 2 篇分別用 LightX2V LoRA 將速度提升至 4 分鐘左右生成 ; GGUF 將速度提升至 12 分鐘左右生成
Step 2:本篇說明 - 對應規格
若硬體設備遠高於此,基本上 VRAM 不足的問題應不容易發生,可不用檢閱此篇內容
| 項目 | 規格 |
|---|---|
| GPU | 名稱 NVIDIA GeForce RTX 5070 (12G VRAM) |
| CPU | Intel(R) Core(TM) i7-8700 CPU @ 3.20GHz,3192 Mhz,6 個核心,12 個邏輯處理器 |
| RAM | 48 GB |
| OS | Microsoft Windows 10 專業版 |
第二部分:優化工作流-導入 LightX2V LoRA + GGUF 量化模型
Step 1:前言
原理的部分可參前篇的文章
0110. 動態與速度兼得:如何用 LightX2V LoRA 替代傳統採樣算法,解放消費級顯卡的 Wan 2.1 影片生成潛力
0111. 動態與速度兼得:打破顯示卡 12GB 顯存限制!實戰 ComfyUI 導入 Wan 2.1 GGUF 量化模型提升速度保持影片品質
LightX2V LoRA 的模型必須要與 GGUF 的版本一致,因此我們這篇文章統一都會用 Wan 2.1 版本的模型說明如何整合,目標版本:
LightX2V LoRA :  Wan21_I2V_14B_lightx2v_cfg_step_distill_lora_rank64.safetensors
GGUF : wan2.1-i2v-14b-480p-Q5_K_M.gguf
※這邊 noise 下載 low 版本目的追求細節豐富、靜態或輕微動作的影片。
※high 適合動態大、運動幅度明顯的影片,總之 LoRA 與 GGUF 一定要一致,避免異常
Step 2:下載對應模型 - GGUF
GGUF 的 Wan 2.1 版本,可以到 Hugging Face 下載,連結
下載檔案名稱 wan2.1-i2v-14b-480p-Q5_K_M.gguf.gguf 後放進以下目錄
ComfyUI/
└── models/
    └── diffusion_models/
        ├── wan2.1-i2v-14b-480p-Q5_K_M.gguf

Step 3:下載對應模型 - LightX2V LoRA
LightX2V LoRA 的 Wan 2.1 版本,可以到 Hugging Face 下載,連結,如下圖
下載檔案名稱 Wan21_I2V_14B_lightx2v_cfg_step_distill_lora_rank64.safetensors 後放進以下目錄
ComfyUI/
└── models/
    └── loras/
        ├── Wan21_I2V_14B_lightx2v_cfg_step_distill_lora_rank64.safetensors

Step 4:導入 GGUF - 增加加載器與 LoRA
最初篇文章的工作流步驟如下:
UNet加載器
    └─ 模型 ──→ 模型 ──→ K采樣器
加載CLIP
    └─ CLIP ──→ CLIP ──→ CLIP Text Encode
我們目標是添加 GGUF + LightX2V LoRA 模型,順序必須是 GGUF 先,然後才是 LoRA
UNET 加載器 (GGUF) + LoRA 模型
    └─ 模型 ──→ Load LoRA ──→ 模型 ──→ K采樣器
加載CLIP
    └─ CLIP ──→ CLIP ──→ CLIP Text Encode
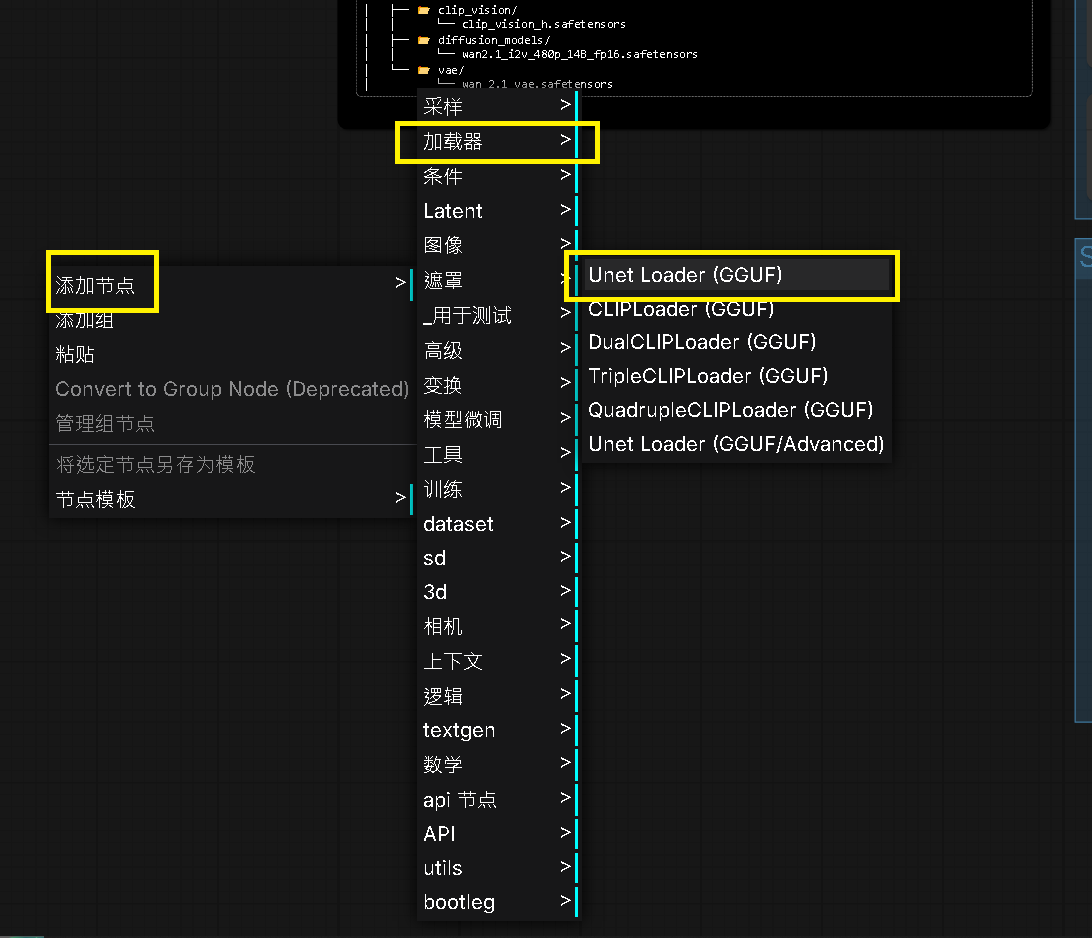
因此先在 ComfyUI 空白處,添加 UNET 加載器 (GGUF)
這時有可能會出現沒有找到的狀況,這時就要對 ComfyUI 做外掛安裝 ComfyUI-GGUF
若是沒有選項可參考此篇 Step11 ~ Step13步驟
Step 5:ComfyUI 工作流 - 替換模型
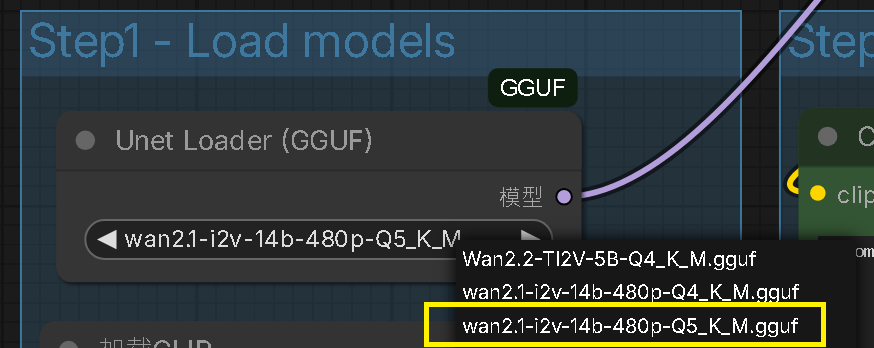
接著將 UNet 替換掉,並且將剛剛下載的模型 (wan2.1-i2v-14b-480p-Q5_K_M.gguf) 選取
Step 6:ComfyUI 工作流 - 添加 LoRA 加載器
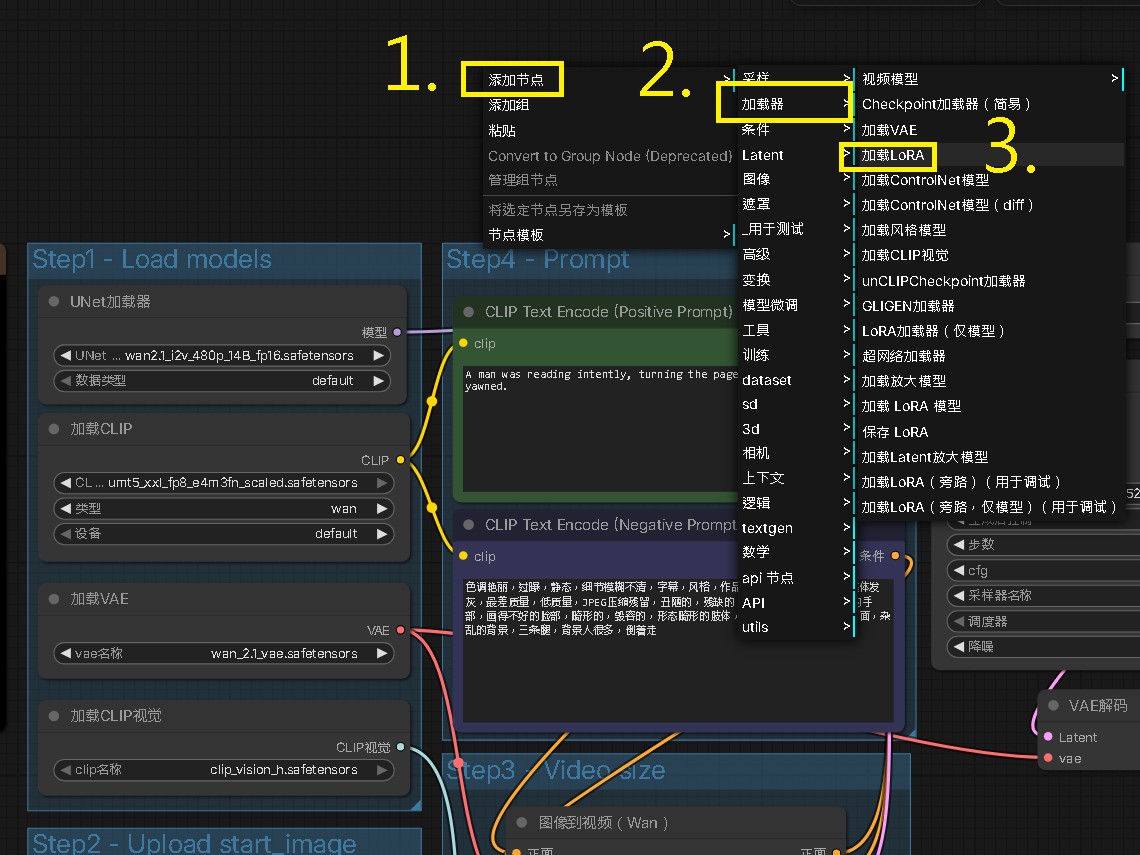
在 ComfyUI 空白處,添加 LoRA 加載器
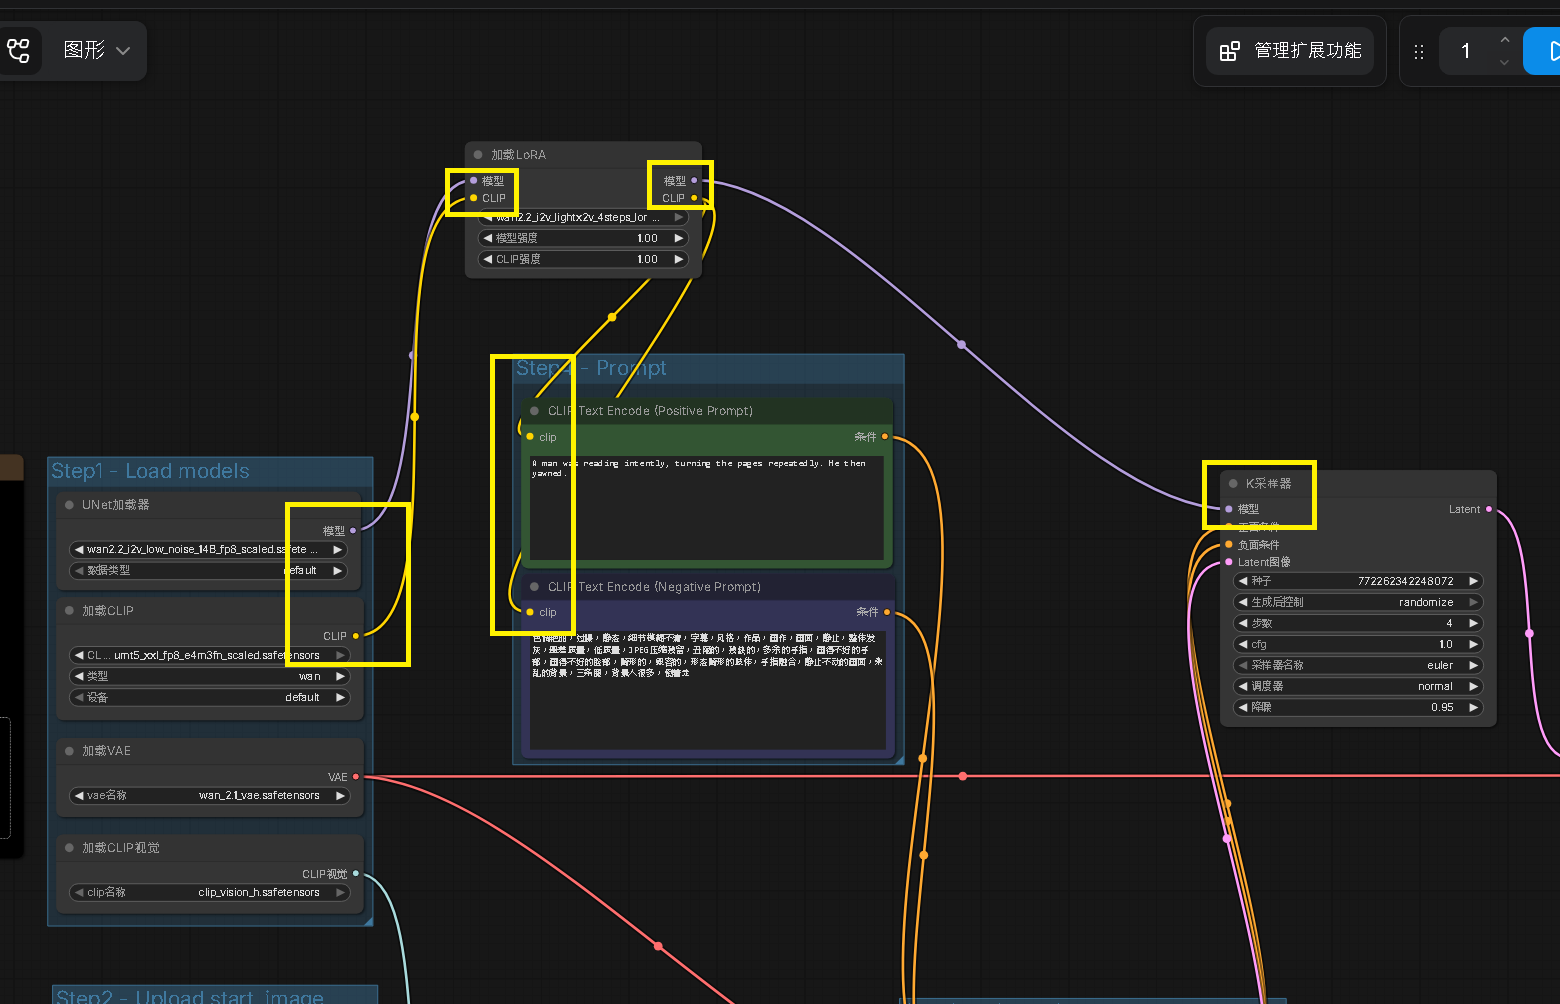
Step 7:ComfyUI 工作流 - 調整 LoRA 加載器節點
接著如下圖將 Loar 加載器的輸入、輸出,節點調整
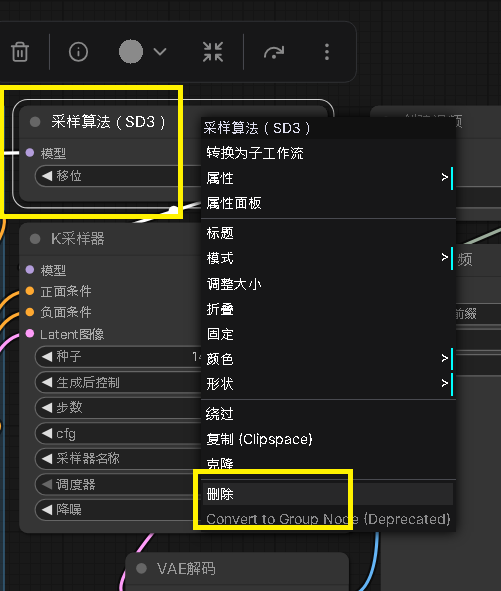
Step 8:ComfyUI 工作流 - 必須移除採樣算法SD3
原始模型會需要採樣算法SD3(Stable Diffusion 3),現在是 LoRA 模型因此不需要
※不移除會造成生成錯誤或品質下降
加載LoRA ──模型──→ K采樣器(直接連接,不經過SD3)
Step 9:ComfyUI 工作流 - K採樣器參數調整
K採樣器仍須調整為 4 步,這不可少,否則影片異常率 95 % 以上
| 步數 | 4 | 必須引為 lightx2v 適合 4 步 |
| CFG | 1.0 | 必須符合 |
| 採樣器名稱 | eular | 折衷方案,flow_dpm 為最佳 |
| 調度器 | normal | 折衷方案,simple_linear 為最佳 |
第三部分:驗證成果
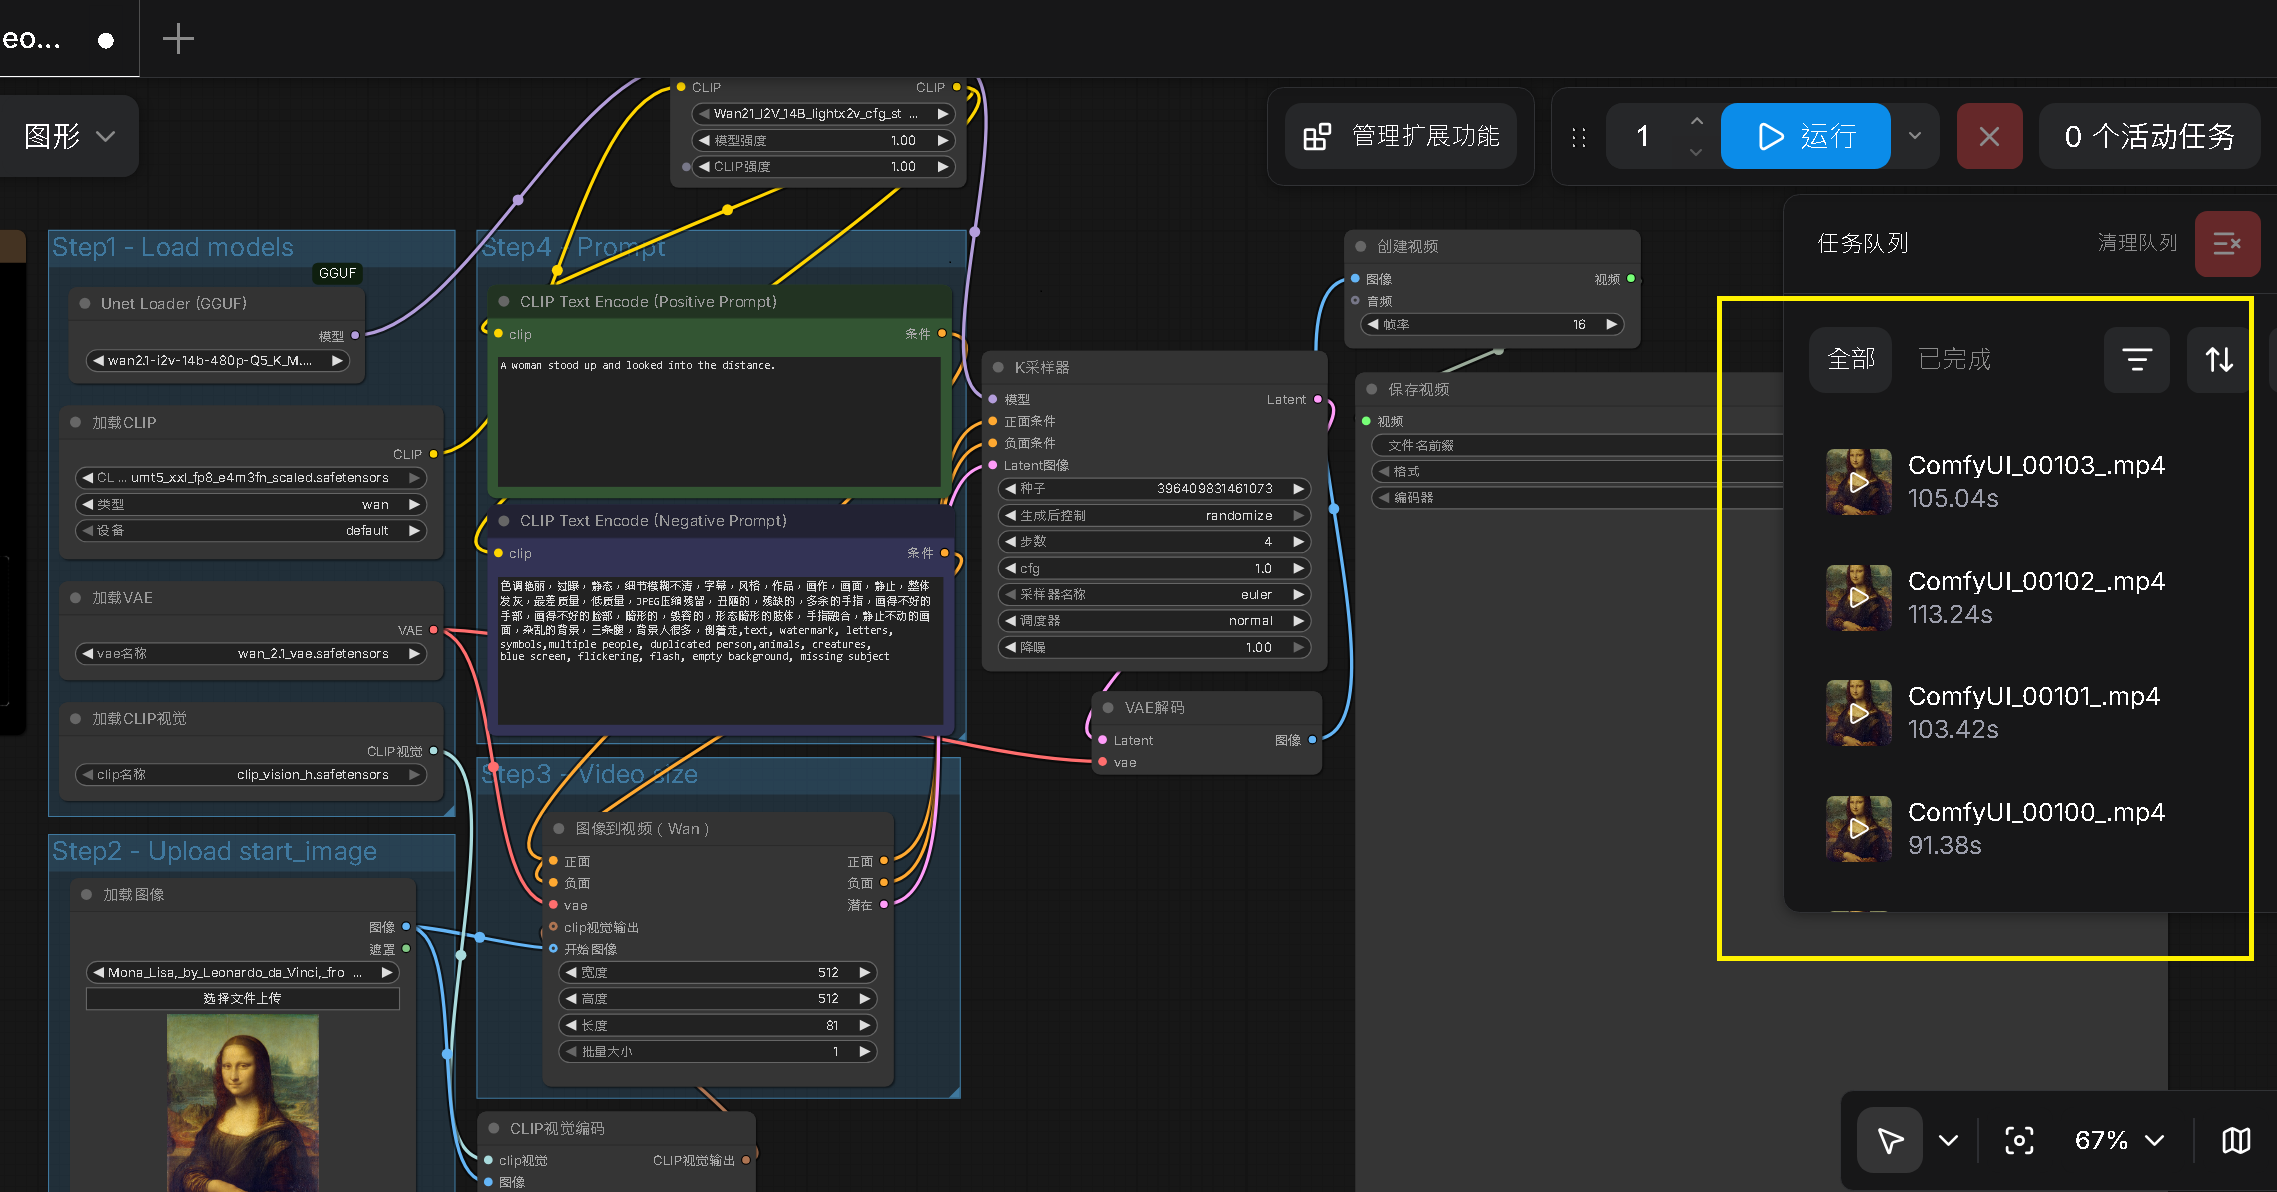
Step 1:開始執行 ITV - DEMO結果
圖片更換為 蒙娜麗莎的微笑 示意執行,時間提升地很極致,平均約 101 秒左右(91~113 之間)完成生成 5 秒影片
但影片的品質有時出現不穩定的狀況,這與提示詞的命中率 + LoRA 的 V1 版本有很大的關係
在生成 5 次中,其中 1 個可能跑出很糟糕的狀況 - Youtube 播放(其中一個成功的結果):
Step 2:LoRA + GGUF 不穩定說明
LoRA + GGUF 參數調教更複雜,且不穩定
單獨 GGUF:調整空間大,CFG 可以正常使用
單獨 LoRA:固定 CFG=1.0 即可
GGUF + LoRA:需要同時考慮兩者的限制
            → 更難找到最佳參數組合
因此穩定性容易下降,GGUF 量化誤差 + LoRA 大步數 → 兩個誤差疊加
速度的優點被放大了,但是調教的精準度的誤差也相對應提高
Step 3:未來解決方案
GGUF 模型本身已經沒問題了,單當前問題在於 LightX2V 使用的是 V1 單階段,可以更進一步使用 V2 雙接端(高噪音 + 低噪音)
影片的不穩定在於噪音的修正效果
V2 提供全加速和半加速兩種模式:
1. 全加速將 LoRA 同時套用在高噪音和低噪音兩個階段,強度 1.0,達到最大速度;
2. 半加速只將 LoRA 套用在低噪音修飾階段,提供更好的 Prompt 控制。

雜訊 →(高噪音階段 4~7步)→ 粗略結構
     →(低噪音階段 4~7步)→ 細節修飾 → 完成
因此 V2 可以大幅解決穩定性問題,但 4~7 + 4~7 步的高噪音 + 低噪音處理,生影片速度會拖慢不少
※但仍比最原始的 Wan 20步快很多,並且有 GGUF 先優化 1/2 的速度
Step 4:補充 LoRA Rank
對應 第二部分的 Step 3:下載對應模型 - LightX2V LoRA 進行 Rank 補充
本篇範例用的是 Rank 64 是官方推薦標準等級,簡言之: Rank 越大 → 能表達的修正越精細 → 對模型控制力越強
Rank 是 LoRA 的核心參數,代表「LoRA 修正層的維度大小」。

LoRA 的做法:
[1000 x rank] × [rank x 1000] = 修正值

rank=32:  [1000x32]  × [32x1000]  = 64,000 個數值
rank=64:  [1000x64]  × [64x1000]  = 128,000 個數值
rank=128: [1000x128] × [128x1000] = 256,000 個數值
各等級的差異說明:
| Rank | 檔案大小 | 控制力 | 穩定性 | 速度影響 | 適合情境 |
|---|---|---|---|---|---|
| Rank4 | 45MB | 最弱 | 最低 | 幾乎無 | 快速測試 |
| Rank8 | 82MB | 很弱 | 低 | 幾乎無 | 硬體極限制 |
| Rank16 | 156MB | 弱 | 中低 | 極小 | 輕量使用 |
| Rank32 | 305MB | 中等 | 中 | 小 | 入門推薦 |
| Rank64 | 704MB | 強 | 高 | 小 | 中高階單一顯卡 |
| Rank128 | 1.4GB | 很強 | 很高 | 略有 | 追求最高品質 |
| Rank256 | 2.8GB | 最強 | 最高 | 最大 | 專業用途 |