日期:2026年 10月 03日
標籤: Linux Ubuntu Docker Docker-Compose ComfyUI WSL 2.2 Music Generation ACE-STEP 1.5 TextEncodeAceStepAudio1.5 Diffusion Transformer VAE AI Music
摘要:生成式AI
應用所需:1. 已安裝並可正常執行 ComfyUI,且版本需包含 ACE-STEP 1.5 原生節點
2. 準備歌曲風格描述(Tags)與歌詞(Lyrics);若只生成配樂則使用結構標記
解決問題:1. 不熟悉樂理或編曲軟體,也能在本機以文字建立一首包含段落結構的音樂
2. 透過 BPM、調性、拍號、語言與 Seed,有系統地比較生成結果
ComfyUI 官方教學:ACE-Step 1.5 Music Generation Guide
核心節點說明:TextEncodeAceStepAudio1.5
ACE-STEP 1.5 專案:ace-step / ACE-Step-1.5
官方寫歌教學:ACE-Step 1.5 Tutorial
本篇範例最終工作流載點分享:點擊下載
版本提醒:ACE-STEP 1.5 是目前 ComfyUI 原生支援的新工作流,請勿與舊版 ACE-Step 1.0 的模型及 TextEncodeAceStepAudio 節點混用
本篇分為 4 大部分。
第一部分:問題描述
第二部分:ACE-STEP 1.5 音樂生成工作流
第三部分:驗證成果 & 優化
第四部分:分析、遺留問題探討
第一部分:問題描述
Step 1:想用 AI 寫歌,真正困難的不只是輸入一句 Prompt
過去使用文字生成圖片時,只要描述主體、場景與畫風,就有機會得到可用的畫面。
但一首完整音樂同時 包含曲風、速度、調性、樂器、人聲、歌詞、段落與時間 ,控制條件太多了。
一首歌
├─ 整體設定:曲風、情緒、年代感、樂器與製作品質
├─ 音樂資訊:BPM、拍號、調性與歌曲長度
├─ 時間結構:Intro、Verse、Chorus、Bridge、Outro
├─ 人聲內容:語言、歌詞、咬字、唱法與和聲
└─ 隨機變化:Seed、歌曲規劃取樣與擴散取樣
如果只輸入 a pop song,模型必須自行猜測幾乎所有條件;每次產生的歌曲自然會有很大的差異。
本篇的目標不是一次抽到完美歌曲,而是說明 如何調整參數來創造音樂 ,並說明 ACE-STEP 1.5 ComfyUI 工作流。
Step 2:ACE-STEP 1.5 是什麼?
ACE-STEP 1.5 是開源音樂生成模型,ComfyUI 已提供原生工作流與核心節點。
它採用混合式架構:先由 Language Model 整理歌曲藍圖,再交給 Diffusion Transformer(DiT)完成音訊合成。
Tags + Lyrics + 音樂參數
             ↓
Language Model:理解需求、規劃歌曲與產生 Audio Codes
             ↓
Conditioning + Empty Audio Latent
             ↓
Diffusion Transformer:生成音訊 Latent
             ↓
VAE Decode:還原為可播放的 Audio
這種設計的重點,是讓長篇歌曲的結構規劃與音訊生成各自負責不同工作。
因此它不只是「文字轉聲音」,而是能接收 歌詞、段落、BPM、拍號、調性與語言 等條件的完整音樂生成流程。
Step 3:TextEncodeAceStepAudio1.5 節點扮演什麼角色?
TextEncodeAceStepAudio1.5 是本篇最重要的條件編碼節點。
它會接收 CLIP、Tags、Lyrics 與音樂參數,最後輸出 CONDITIONING 給後續的取樣器。
| 輸入類型 | 主要用途 | 範例 |
|---|---|---|
| tags | 描述整首歌的整體聲音 | synthwave, nostalgic, female vocal, analog synth |
| lyrics | 歌詞與歌曲發展順序 | [Intro]、[Verse]、[Chorus]、[Outro] |
| bpm | 每分鐘拍數 | 90、120、128 |
| duration | 希望生成的秒數 | 30、60、120 |
| timesignature | 拍號選項 | 2、3、4、6 |
| language | 歌詞語言 | en、zh、ja、ko 等 |
| keyscale | 調性 | C major、A minor、E minor |
| seed | Language Model 規劃階段的隨機種子 | 0、123456 |
需要注意:這個節點負責準備歌曲條件,並不是單靠它就能直接輸出 WAV 或 MP3。
後方仍需連接模型取樣、Audio VAE 解碼與音訊輸出節點。
Step 4:Tags 與 Lyrics 不應寫成同一件事
官方 ACE-STEP 教學將 Caption,也就是 ComfyUI 節點中的
「tags」 視為整首歌的 「整體畫像」
「lyrics」 則像歌曲沿著時間前進的 「腳本」
Tags:曲風、情緒、樂器、人聲、音色、製作風格
Lyrics:段落順序、真正要演唱的文字、段落能量與演奏提示
例如想製作一首懷舊城市流行歌曲,可以這樣分工:
tags:
city pop, nostalgic, warm female vocal, electric piano,
clean guitar, melodic bass, analog synthesizer, polished studio mix

lyrics:
[Intro - instrumental]

[Verse 1]
夜色落在街角
霓虹映著微笑

[Chorus - uplifting]
沿著風向前奔跑
把昨天輕輕忘掉
補充:若 Tags 寫「安靜的鋼琴獨奏」,Lyrics 卻要求 [Guitar Solo - distorted],兩邊的條件互相衝突 生成品質可能會下降
Step 5:本篇預計完成的歌曲規格
為了降低第一次生成的時間與顯示記憶體壓力,本篇先做一段 60 秒的中文 City Pop,再逐步調整。
| 項目 | 基準設定 |
|---|---|
| 曲風 | City Pop / Synth Pop |
| 人聲 | Warm female vocal |
| BPM | 112 |
| 拍號 | 4 |
| 調性 | A minor |
| 語言 | zh |
| 長度 | 60 秒 |
| Batch Size | 1 |
| 用途 | 教學測試,非最終母帶 |
後續比較時會固定大多數參數,每一輪只改一個變因,避免聽完仍不知道差異來自哪裡。
Step 6:本篇說明 - 對應規格
以下是本次預計測試的環境:
| 項目 | 本次環境 |
|---|---|
| GPU | NVIDIA GeForce RTX 5070(12 GB VRAM) |
| CPU | Intel(R) Core(TM) i7-8700 CPU @ 3.20GHz,3192 Mhz,6 個核心,12 個邏輯處理器 |
| RAM | 48 GB |
| OS | Microsoft Windows 10 專業版 |
| 所需模型 | acestep_v1.5_turbo.safetensors |
| qwen_0.6b_ace15.safetensors | |
| qwen_1.7b_ace15.safetensors | |
| ace_1.5_vae.safetensors |
※音樂生成模型 GPU 12 VRAM 是完全可以支援的,相對於生成影片消耗的算力門檻低很多
第二部分:ACE-STEP 1.5 音樂生成工作流
Step 1:快速上手 - 使用模板
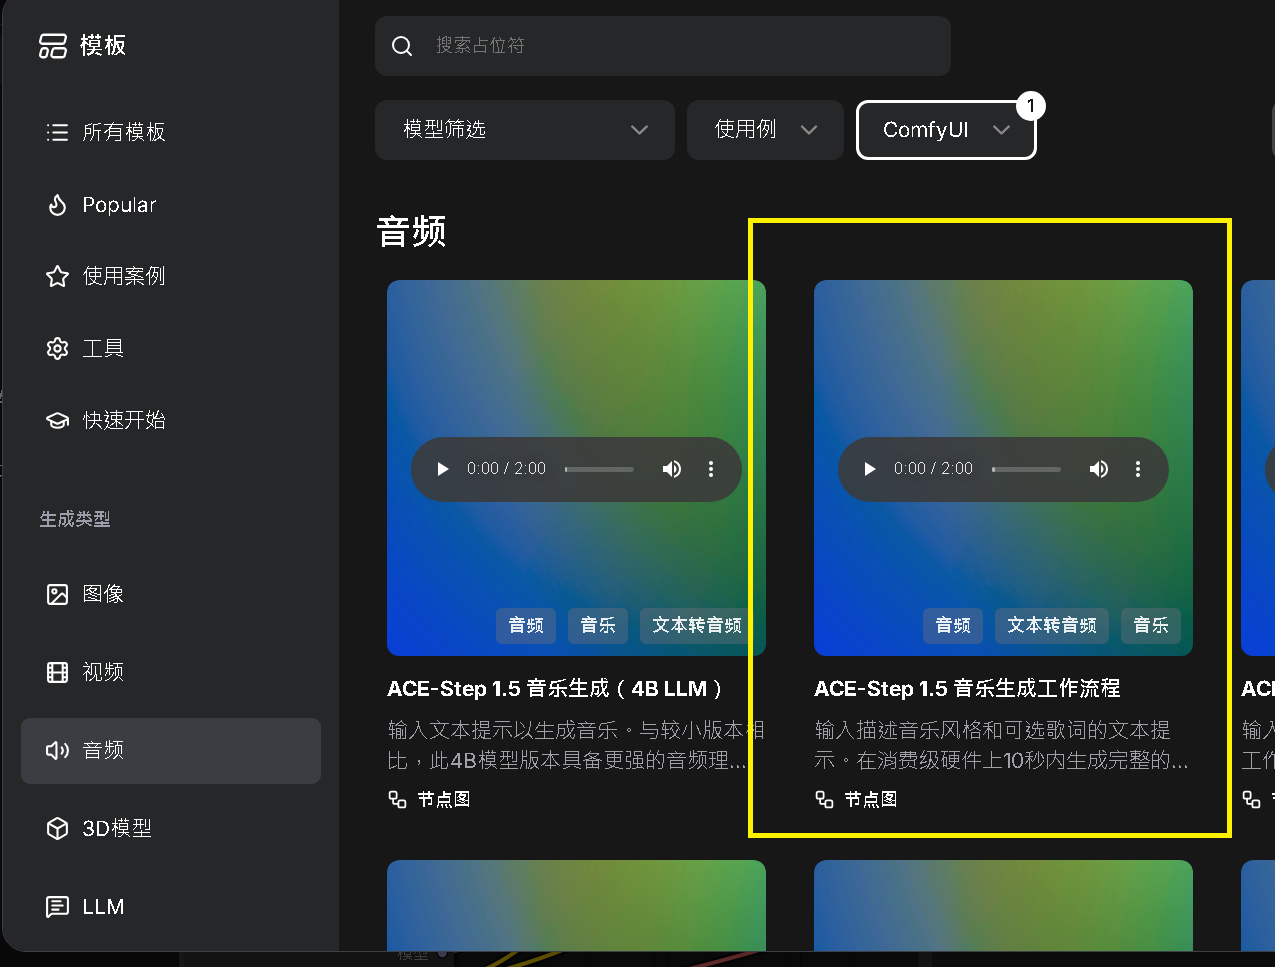
ACE-STEP 1.5 已整合為 ComfyUI 原生節點 ,因此這篇基本的 Text-to-Music 工作流可以直接從 Template 匯入
開啟 ComfyUI 後,左側選擇模板 (Template) -> 音頻 -> ACE-Step 1.5 音樂生成工作流程
Step 2:完整工作流 - 大綱
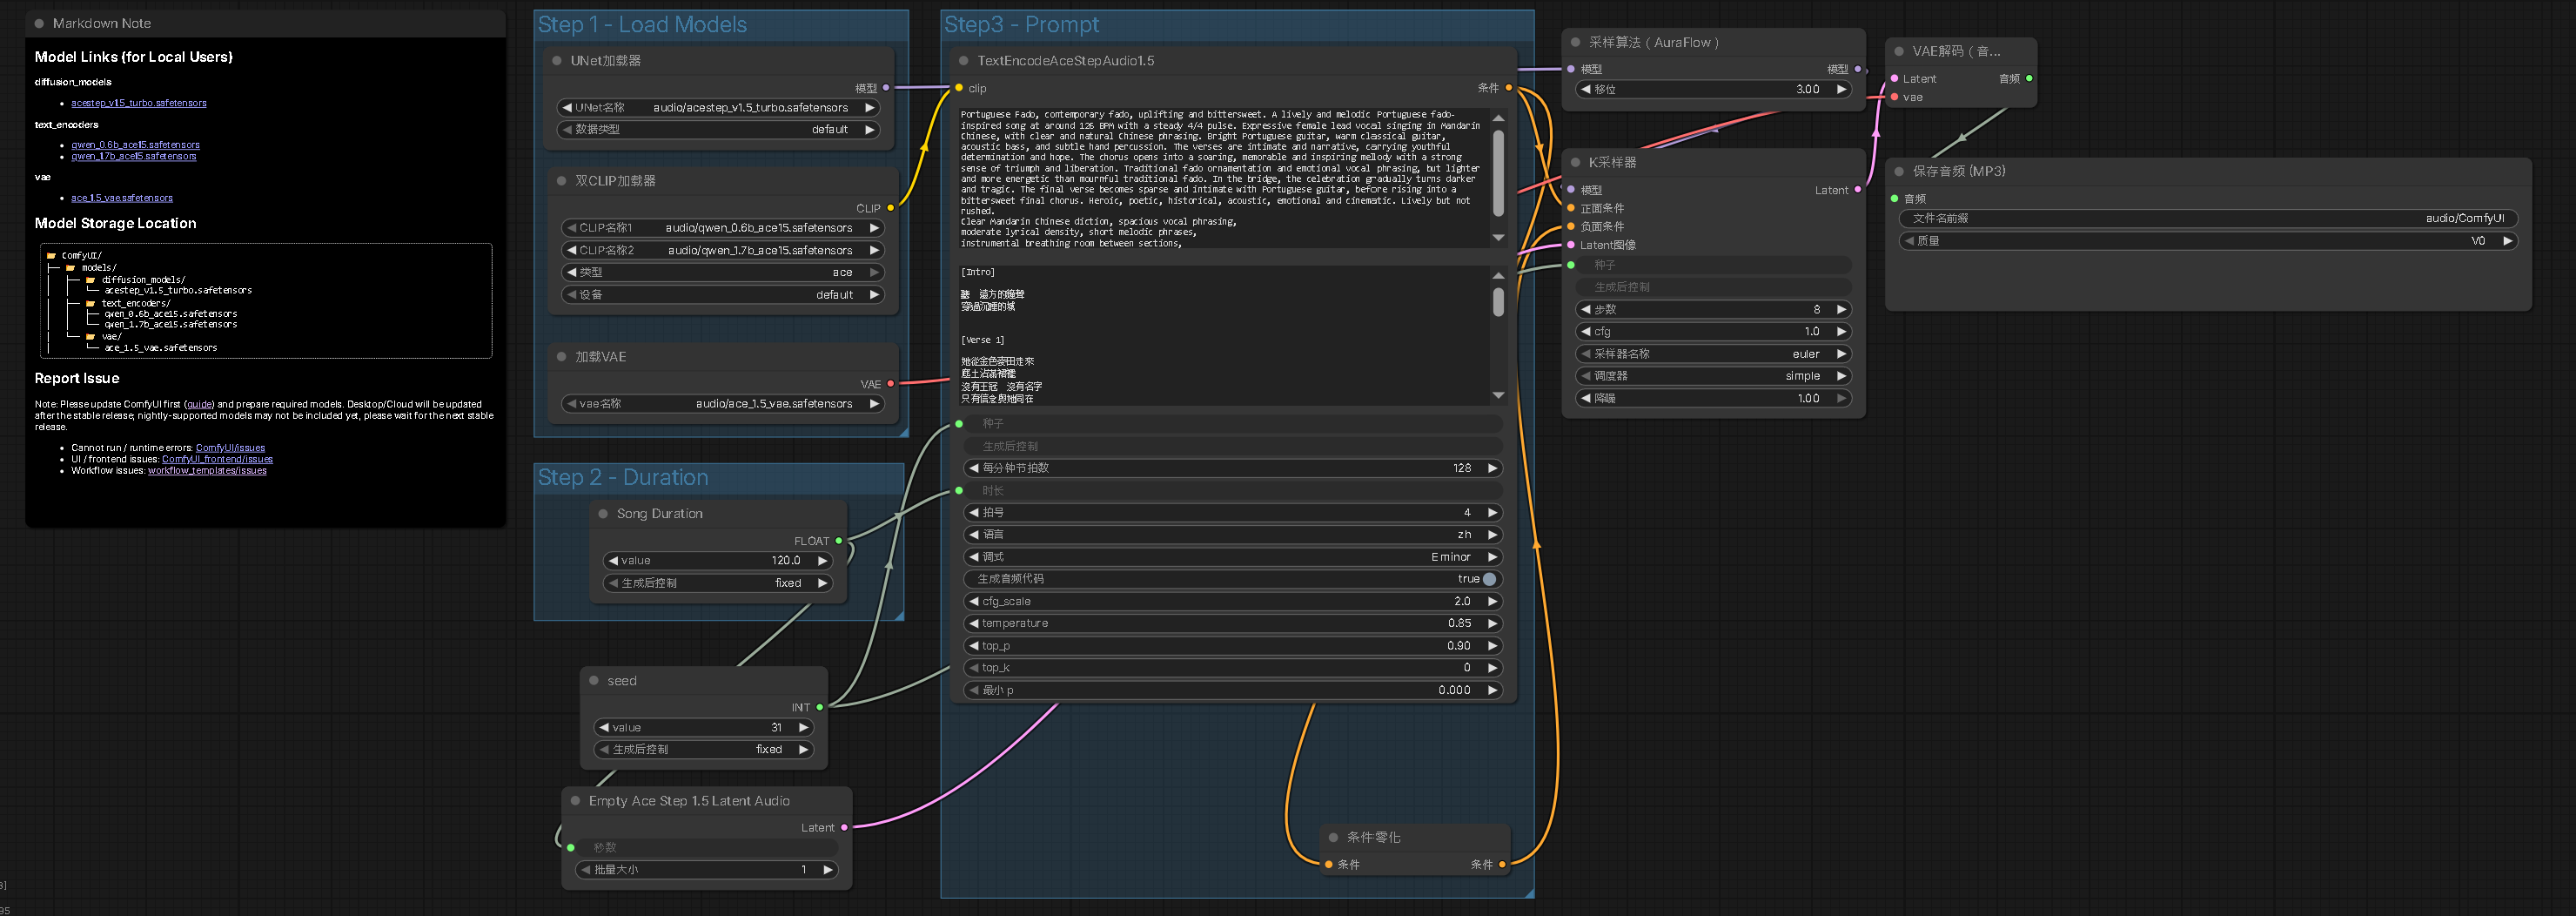
官方工作流可整理成以下4個區塊:
在 step3 之後則是輸出保存音樂的相關節點整合,因此核心為此 4 大塊
| 工作流區塊 | 功能 |
|---|---|
| Markdown Note | (Model Link) 補充下載模型、存放位置 |
| Step 1 - Load models | 讀取模型,與加載 |
| Step 2 - Duration | 設定音樂、曲子的長度 |
| Step 3 - Prompt | TextEncodeAceStepAudio1.5 節點配置,也是歌詞曲風的核心節點 |
Step 3:安裝所需擴充
開啟 ACE-Step 1.5 模板後,如果是第一次使用會需要安裝對應的擴充節點
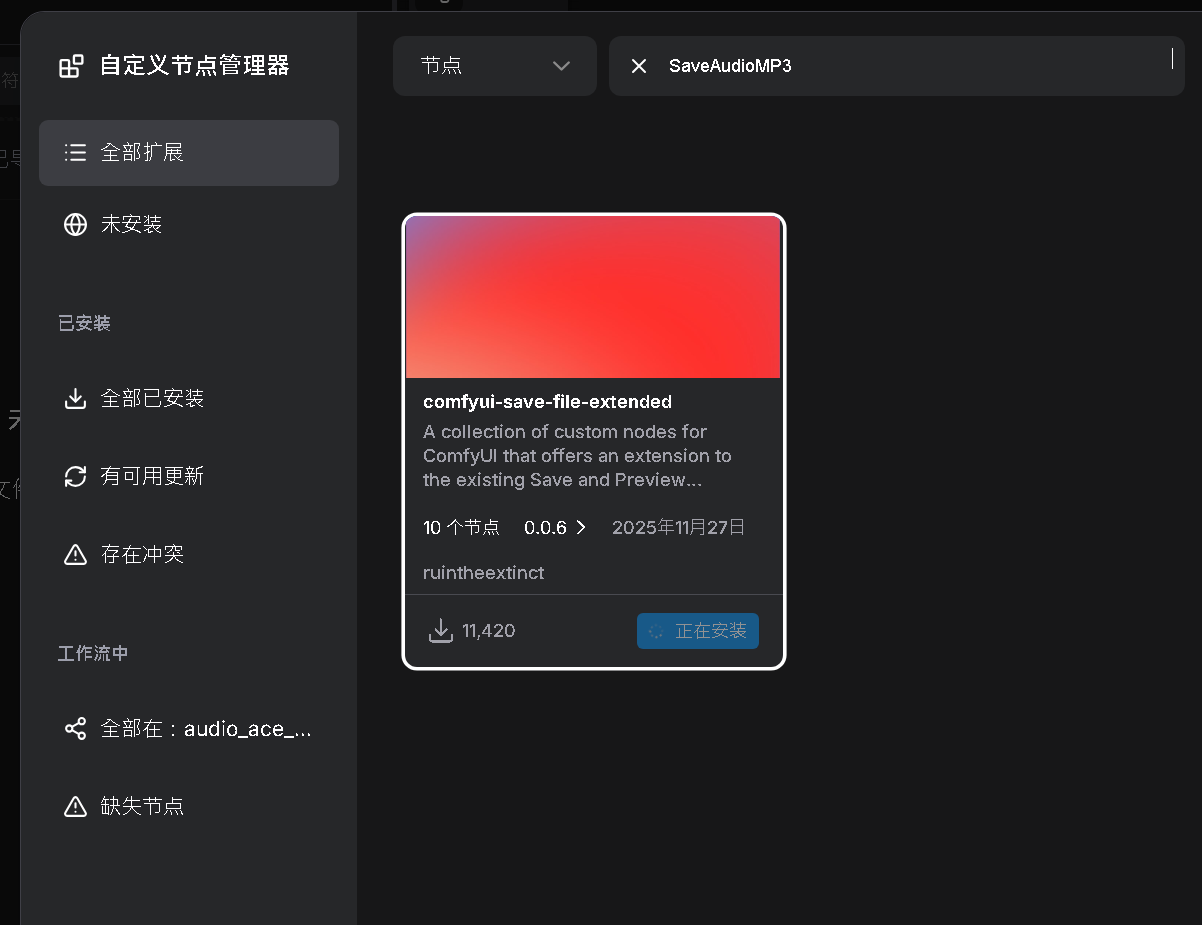
VAEDecodeAudio
SaveAudioMP3
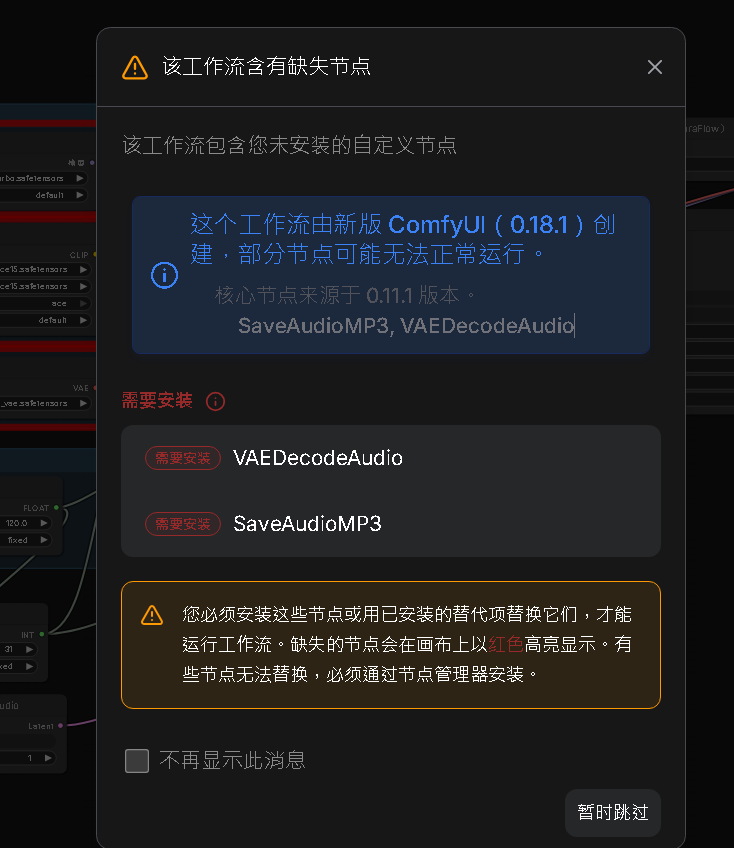
左側菜單 -> 管理擴展工具 -> 節點輸入上述兩個關鍵詞的工具 -> 依序安裝完成
安裝完成後重啟 ComfyUI 的 Docker Container 使其正確啟動應用
Step 4:Model links - 下載模型
預設會出現所需模型安裝提示
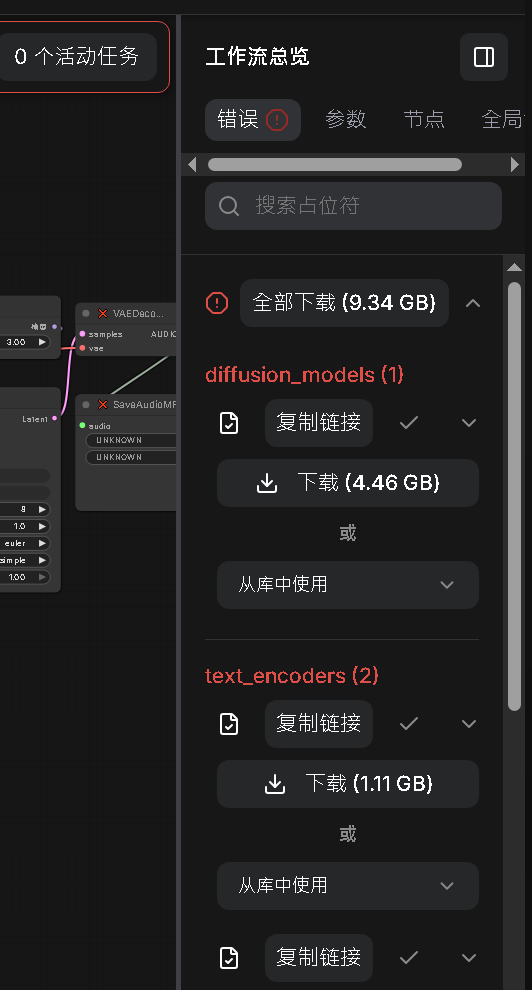
以下是所需模型
| 模型名稱 | 對應目錄 |
|---|---|
| acestep_v1.5_turbo.safetensors | models/diffusion_models/ |
| qwen_0.6b_ace15.safetensors | models/text_encoders/ |
| qwen_1.7b_ace15.safetensors | models/text_encoders/ |
| ace_1.5_vae.safetensors | models/vae/ |
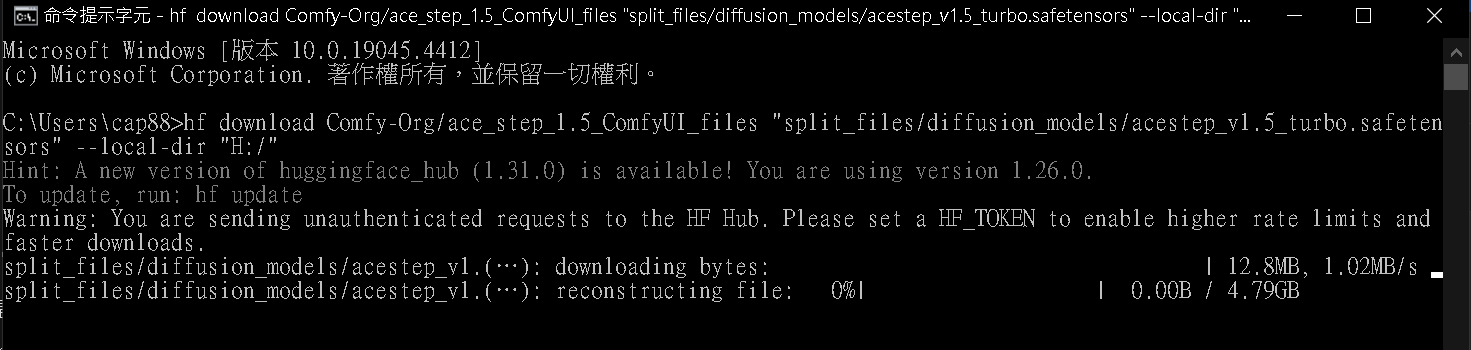
並且附上對應的 HF 指令,便於快速下載, –local-dir 為路徑,可依照自己的環境調整
hf download Comfy-Org/ace_step_1.5_ComfyUI_files "split_files/diffusion_models/acestep_v1.5_turbo.safetensors" --local-dir "H:/"
hf download Comfy-Org/ace_step_1.5_ComfyUI_files "split_files/text_encoders/qwen_0.6b_ace15.safetensors" --local-dir "H:/"
hf download Comfy-Org/ace_step_1.5_ComfyUI_files "split_files/text_encoders/qwen_1.7b_ace15.safetensors" --local-dir "H:/"
hf download Comfy-Org/ace_step_1.5_ComfyUI_files "split_files/vae/ace_1.5_vae.safetensors" --local-dir "H:/"
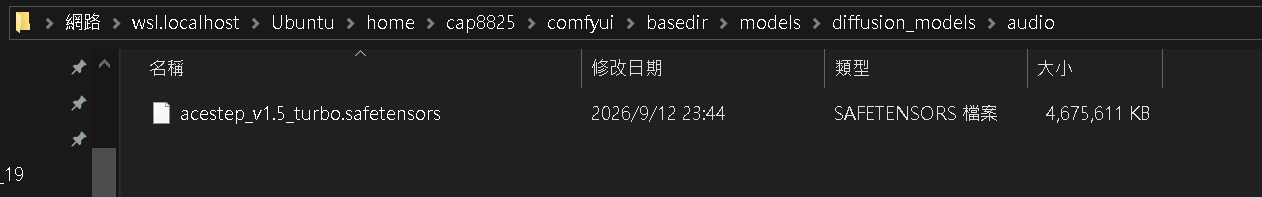
最後將上述下載的模型放進對應的目錄下
Step 5:設定音樂長度
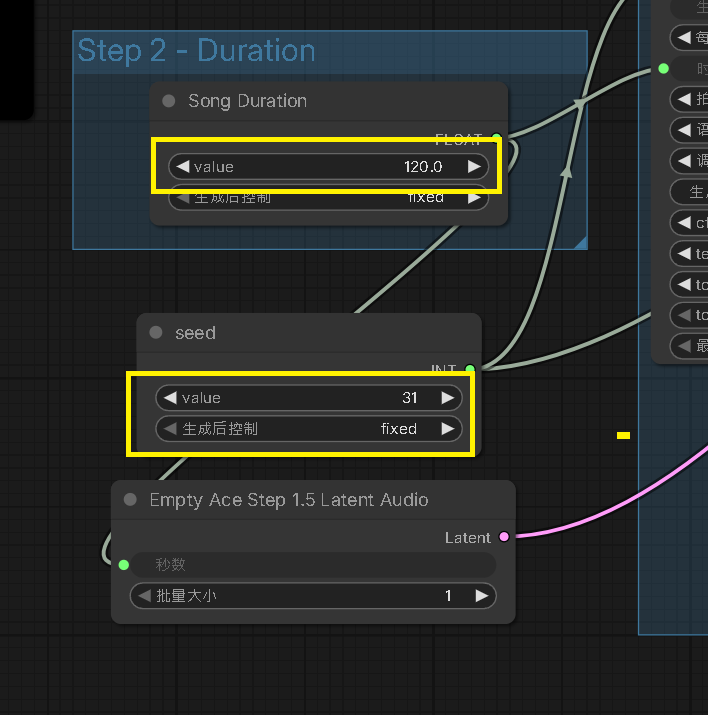
基本上模型存放正確,並安裝正確節點後,可以從 Step 2. Song Duration 開始設定
預設音樂長度為 120 秒,因此要考慮的是音樂的歌詞長度盡量符合
在調適的初期,可以將 Seed 設定為 Fixed ,當曲風符合需求後,再開始調整此種子參數,進行變化
Step 6:嘗試設定曲風
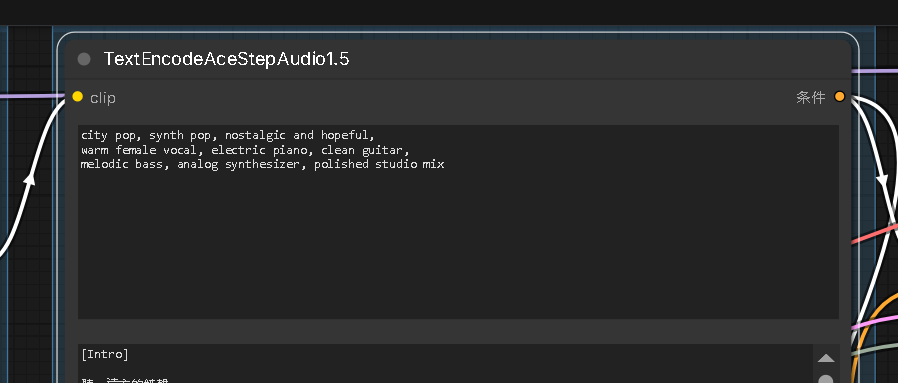
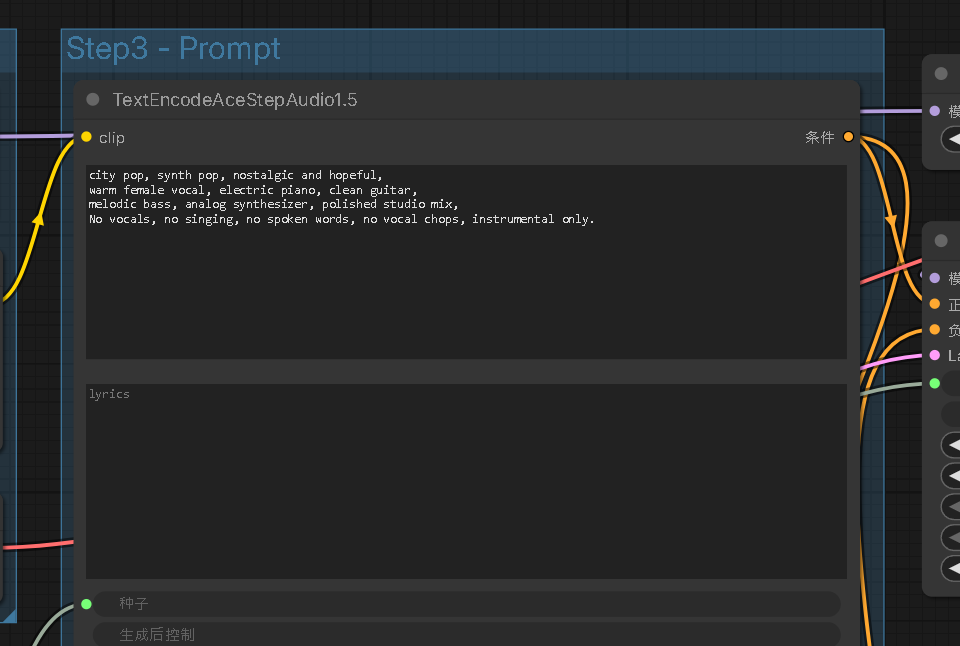
Tags 建議由「曲風 → 情緒 → 樂器 → 人聲 → 製作感」依序描述,先從 5~10 個彼此一致的特徵開始。
city pop, synth pop, nostalgic and hopeful,
warm female vocal, electric piano, clean guitar,
melodic bass, analog synthesizer, polished studio mix
※避免一開始堆入大量互相衝突的詞,例如同時要求極簡鋼琴、重金屬失真、無人聲與女聲主唱。
描述越短,模型創作空間越大;描述越明確,方向通常越集中,但不代表每個詞都會百分之百被執行。
Step 7:設定 Lyrics 與歌曲結構
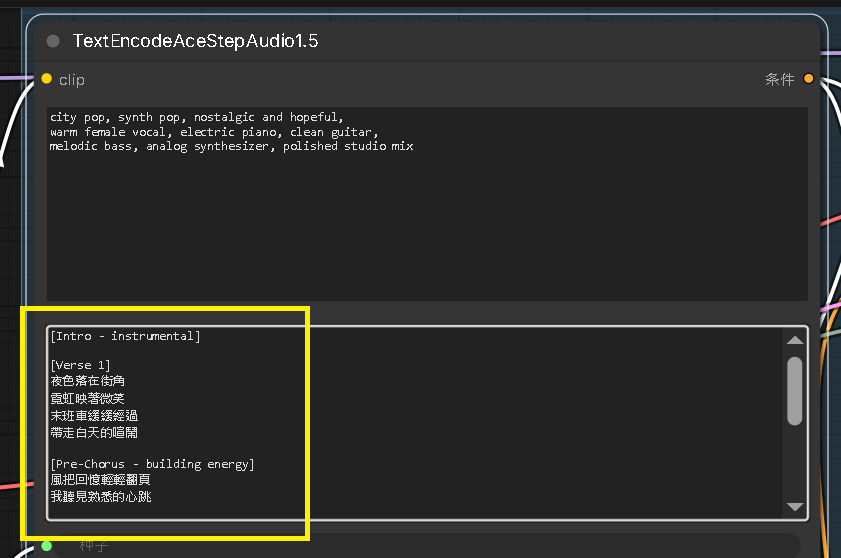
接著下方的部分是 Lyrics ,不單純只放歌詞,也負責描述歌曲隨時間發展的段落。常用結構標記如下:
| 標記 | 用途 |
|---|---|
| [Intro] | 開場與氣氛建立 |
| [Verse] / [Verse 1] | 主歌與敘事推進 |
| [Pre-Chorus] | 進入副歌前的能量堆疊 |
| [Chorus] | 副歌與情緒高潮 |
| [Bridge] | 橋段、轉折或旋律變化 |
| [Instrumental] | 純樂器段落 |
| [Outro] | 收尾 |
| [Fade Out] | 提示淡出結尾,但效果仍具有隨機性 |
本篇測試歌詞:
[Intro - instrumental]

[Verse 1]
夜色落在街角
霓虹映著微笑
末班車緩緩經過
帶走白天的喧鬧

[Pre-Chorus - building energy]
風把回憶輕輕翻頁
我聽見熟悉的心跳

[Chorus - uplifting]
沿著風向前奔跑
讓星光陪我到破曉
就算明天還很遙遠
今晚也不要停靠

[Instrumental - electric piano solo]

[Outro - fade out]
把未完成的願望
留給下一次破曉
同一段落的每行字數不要差距過大,並在段落之間保留空行,能讓節奏與換段提示更清楚。
※段落與字與字之間的空白,會影響AI生成的停頓,與句子切割
Step 8:設定 BPM、Duration、拍號、語言與調性
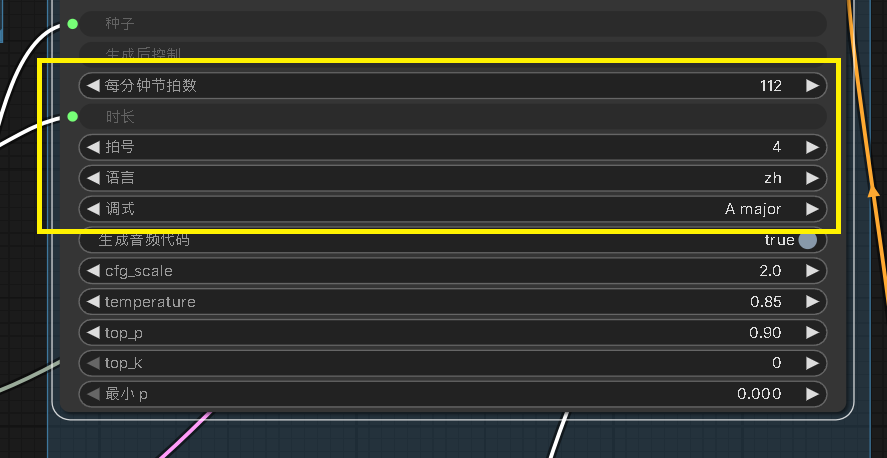
以下是本篇範例的測試參數
| 參數 | 本篇數值 | 說明 |
|---|---|---|
| bpm | 112 | 中等速度,適合本篇 City Pop 測試 |
| duration | 60 | Text Encoder 預期的歌曲秒數 |
| timesignature | 4 | 以四拍系統生成 |
| language | zh | 中文歌詞 |
| keyscale | A minor | A 小調 |
BPM 的可選範圍雖然很廣,仍應選擇符合曲風的合理速度。數值越大曲風越輕快。
Step 9:設定歌曲階段取樣參數
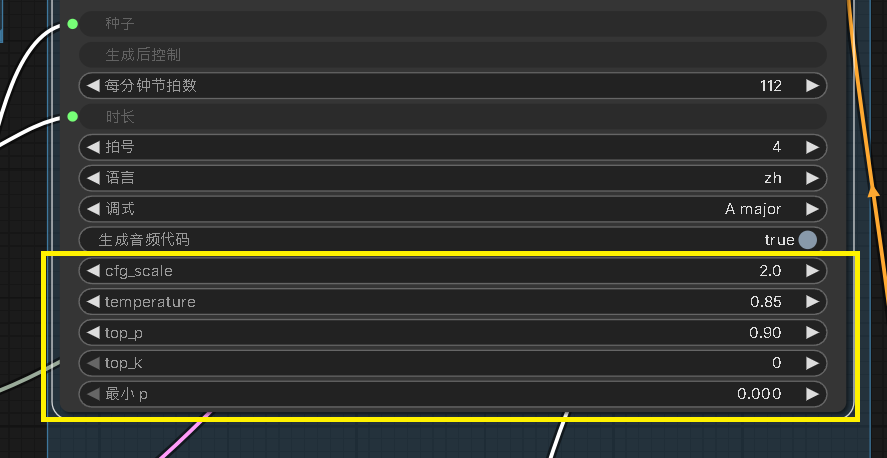
更下方的參數主要影響 語言模型產生歌曲規劃:
| 參數 | 建議起始值 | 作用 |
|---|---|---|
| generate_audio_codes | true | 啟用 LLM 生成 Audio Codes;文字生音樂時建議開啟 |
| cfg_scale | 2.0 | 提高後通常更貼近文字條件,但過高不一定更自然 |
| temperature | 0.85 | 越低越保守,越高變化越大 |
| top_p | 0.9 | 限制 Language Model 的候選 Token 範圍 |
| top_k | 0 | 0 代表先沿用官方預設,不額外限縮 Top-K |
| min_p | 0.0 | 先維持預設值 |
※generate_audio_codes 會增加處理時間,但在純文字生成音樂時通常能提升結果品質。
Temperature、Top-P、Top-K 與 Min-P 是 Language Model 的取樣控制,不是 KSampler 的 Sampler 或 Scheduler,兩者不要混為一談。
Step 10:保持 KSampler
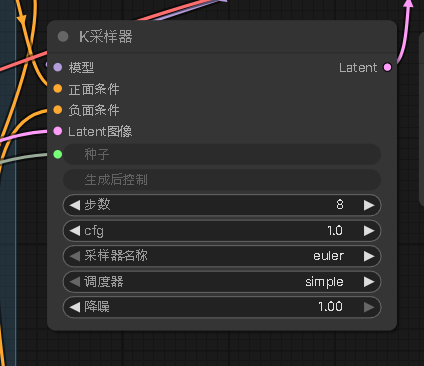
K採樣器第一次測試可直接沿用官方 Template 的參數:
| 參數 | 起始值 |
|---|---|
| steps | 8 |
| cfg | 1.0 |
| sampler_name | euler |
| scheduler | simple |
| denoise | 1.0 |
第三部分:驗證成果 & 優化
Step 1:成果 - 音樂生成結果
以下是第二部分,最終生成結果
基本上歌詞 + 輸出長度 + 提示詞合理,AI的精準度都會很高,至於感情成分見仁見智。
本篇測試歌詞:
[Intro - instrumental]

[Verse 1]
夜色落在街角
霓虹映著微笑
末班車緩緩經過
帶走白天的喧鬧

[Pre-Chorus - building energy]
風把回憶輕輕翻頁
我聽見熟悉的心跳

[Chorus - uplifting]
沿著風向前奔跑
讓星光陪我到破曉
就算明天還很遙遠
今晚也不要停靠

[Instrumental - electric piano solo]

[Outro - fade out]
把未完成的願望
留給下一次破曉
若無法從網頁撥放可以點擊下載
Step 2:優化 - 無人聲的純伴奏版本
很多時候在產出作品或影片時,並不需要人聲,只需要背景音樂,ACE-STEP 1.5 也可以做到
只要將歌詞的部分 清空 然後生成,即可獲得無人聲的伴奏音樂
以下最終生成結果:
若無法從網頁撥放可以點擊下載
第四部分:分析、遺留問題探討
問題 1:找不到 TextEncodeAceStepAudio1.5 節點
可能原因:
| 1. ComfyUI 版本過舊 |
| 2. 使用 Stable 版,但該核心節點尚未進入目前 Stable Release |
| 3. 更新不完整,或啟動時有核心模組載入失敗 |
| 4. 匯入的是 ACE-Step 1.0 工作流 |
先查看啟動記錄,再依官方更新方式升級 ComfyUI。
※ 不要為補一個同名節點,隨意安裝來源不明的 Custom Node
通常所使用的都是 ComfyUI 原生節點,具有一定的可靠性、穩定性。
問題 2:中文歌詞有漏字、錯字或口音不自然
官方節點提供 zh 語言選項,但多語言支援不等於每個字都能完美對準。
建議排查順序:
| 1. language 是否為 zh |
| 2. 每行歌詞是否過長 |
| 3. 同一段落行長是否差距太大 |
| 4. 歌詞總量是否超過 Duration 能容納的範圍 |
| 5. 中英文、數字與特殊符號是否過度混用 |
| 6. 是否堆疊過多 Meta Tags |
| 7. 更換 Seed 重新比較 |
品牌名、人名與罕見讀音可先改成較容易朗讀的同音字或留白,最後再評估是否以專業人聲重新錄製。
問題 3:歌曲尾端突然被切斷或出現大段空白
先確認 Lyrics 是否在短秒數內塞入過多段落,或長秒數卻只提供極少的時間結構。
即使加入 [Outro]、[Fade Out],它們仍是生成提示,並非 DAW 中保證精確執行的自動化指令。
最終發行前可在音訊軟體補做剪輯、淡入淡出與尾端殘響處理。
問題 4:為什麼調高 CFG 或 Steps,結果反而更差?
ACE-STEP 1.5 Turbo 有自己的模型蒸餾與工作流設定,不能直接沿用 Stable Diffusion 圖片生成「Steps 越高越好」的直覺。
而且工作流裡有兩個容易混淆的 Guidance:
| 位置 | 參數 | 影響階段 |
|---|---|---|
| TextEncodeAceStepAudio1.5 | cfg_scale | Language Model / Audio Codes 條件規劃 |
| KSampler | cfg | Diffusion 音訊 Latent 取樣 |
先回到官方 Template 的預設值,再固定 Seed 單獨調整其中一項。
若兩個數值一起提高,可能造成條件過度約束、失真或音樂性下降。
問題 5:生成完成就能直接當作商用音樂嗎?
技術上 可以輸出音訊,不代表法律、授權與發行規範 已自動處理完畢。
- 確認模型授權是否涵蓋預計的商業用途
- 不要在未取得同意時模仿可識別的真人歌手
- 歌詞、旋律、取樣素材與參考音訊都要確認來源
- 保留模型版本、Prompt、Workflow 與生成日期紀錄
- 發行前檢查使用平台對 AI 音樂的標示與權利政策
若作品會進入廣告、串流、遊戲或付費商品,建議另外做相似度檢查並諮詢熟悉所在地法規的專業人士。
本文是技術工作流教學,不構成法律意見。
總結
這篇從 ACE-STEP 1.5 的基本概念開始,完成了 AIO 模型安裝、TextEncodeAceStepAudio1.5 條件設定、Audio Latent、KSampler、VAE Decode 與音訊保存。
真正影響成果的關鍵: 不是單純增加 Steps,而是讓 Tags、Lyrics、BPM、調性、語言與歌曲長度互相一致。
推薦優化順序:
1. 先用官方 AIO Template 成功生成 30~60 秒音訊
2. 固定參數,只更換 Seed 挑選方向
3. 精簡 Tags,排除互相衝突的描述
4. 整理 Lyrics 結構與每行長度
5. 再調整 BPM、Key、Temperature 與其他進階參數
6. 保存 Workflow 與原始音訊,最後交由 DAW 後製
下一步可以延伸研究:參考音訊控制、Cover、Repaint、LoRA 個人化,以及將生成結果送入 DAW 的自動化後製流程。