日期:2026年 09月 26日
標籤: Linux Ubuntu Docker Docker-Compose ComfyUI WSL 2.2 Stable Diffusion SDXL IP-Adapter CLIP Vision Composition Control Image Prompt
摘要:生成式AI
應用所需:1. 已安裝並可正常執行 ComfyUI
2. 建議使用 NVIDIA 顯示卡;本文示例規格為 RTX 5070 + 12 GB VRAM
解決問題:1. 單一參考圖同時帶入畫風、主體與構圖,導致生成結果被參考圖綁死
2. 將「畫風參考」與「佈局參考」拆成兩張圖片,分別調整影響力
3. 透過調整參數,找出合適的最佳參數
IP-Adapter 論文:IP-Adapter: Text Compatible Image Prompt Adapter
自訂節點來源:cubiq / ComfyUI_IPAdapter_plus
官方範例工作流:ipadapter_style_composition.json
Comfy-Org 節點目錄:ComfyUI_IPAdapter_plus
模型來源:h94 / IP-Adapter
本篇範例最終工作流載點分享:點擊下載
維護提醒:原作者已在 2025/04/14 將套件調整為 maintenance-only;更新 ComfyUI 或自訂節點前,建議先備份可用環境與 Workflow JSON
本篇分為 4 大部分。
第一部分:問題描述
第二部分:IP-Adapter ComfyUI工作流
第三部分:驗證成果 & 優化
第四部分:分析、遺留問題探討
第一部分:問題描述
Step 1:只用文字描述畫風,為什麼總是不夠精準?
一般 SDXL (Stable Diffusion XL)工作流主要依靠 Positive Prompt 描述圖片內容,例如:
a perfume bottle on a table,
Japanese woodblock print style,
indigo and beige color palette,
flat shapes, rough paper texture,
soft morning light
文字能指出大方向,卻很難完整表達筆觸密度、配色比例、材質顆粒、邊緣處理與整體視覺節奏。
即使使用相同 Prompt,不同 Checkpoint 對 「Japanese woodblock print」 的理解也可能完全不同。
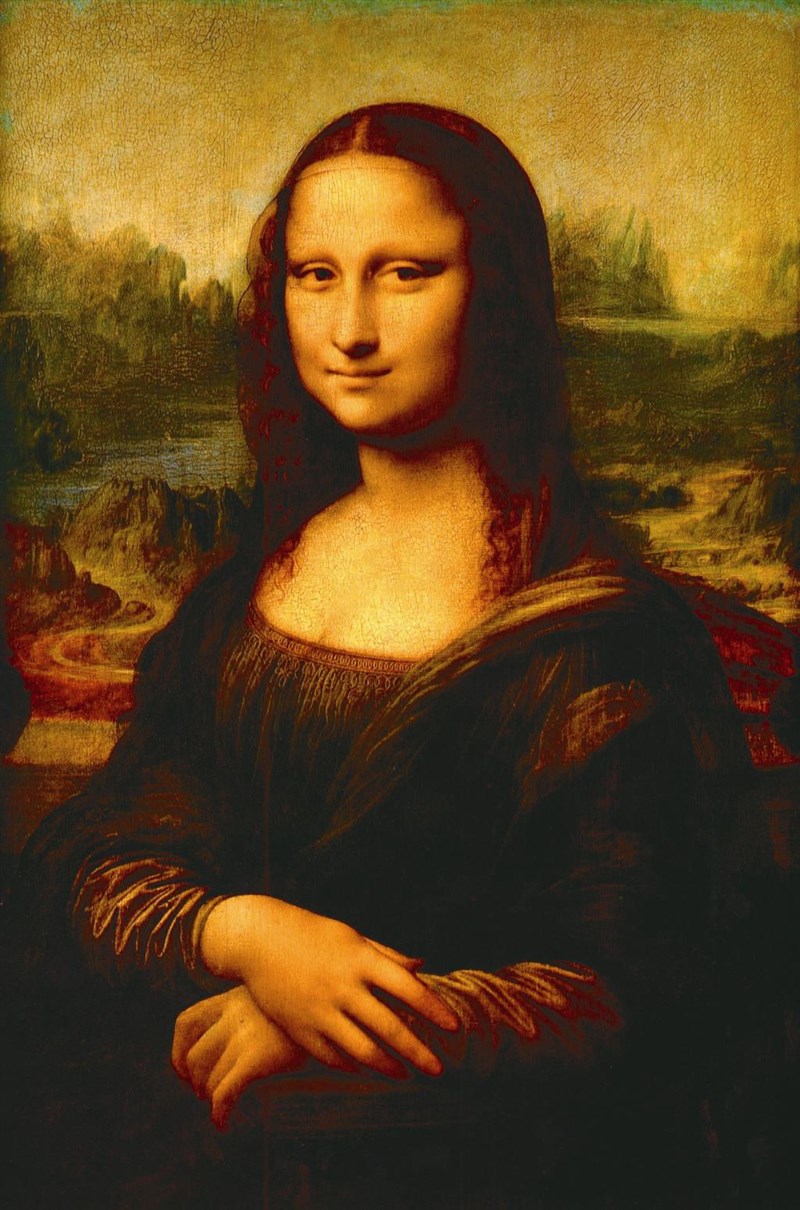
達文西的畫作風格: 《蒙娜麗莎》擅長捕捉人物微妙的表情與內心世界
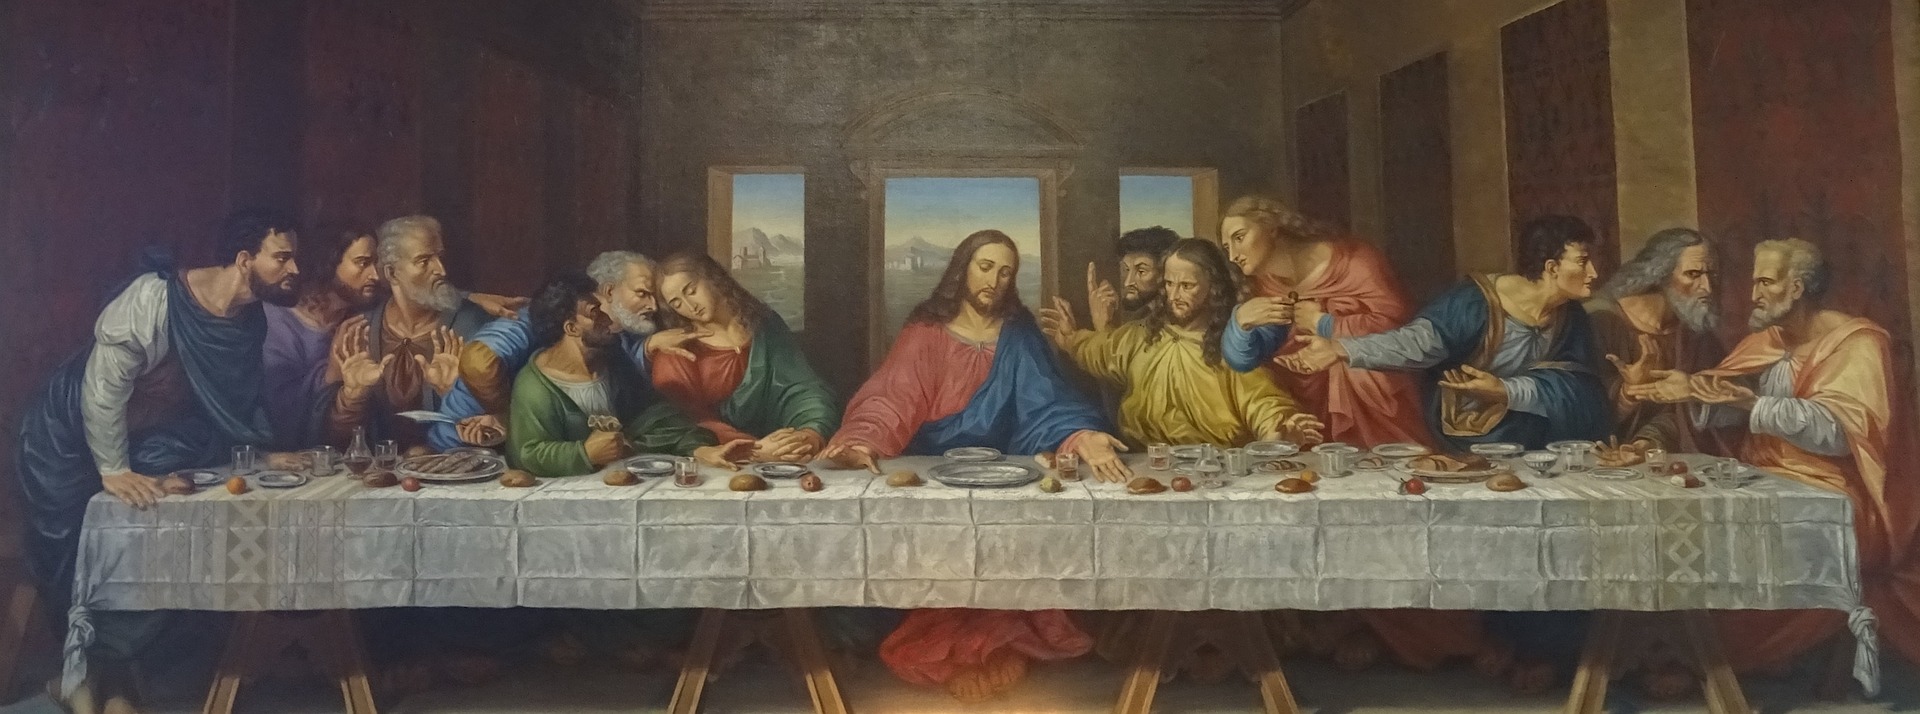
達文西的畫作風格: 《最後的晚餐》具有戲劇張力。
Step 2:單張參考圖的「特徵糾纏」
IP-Adapter 可以將圖片當成 Image Prompt。最簡單的工作流只需要一張參考圖,但這張圖片往往同時包含多種訊息:
參考圖
├─ 畫風:油畫、攝影、插畫、材質與配色
├─ 佈局:主體位置、大小、視角與留白
├─ 內容:人物、商品、背景與裝飾
└─ 細節:表情、文字、Logo 與局部物件
當權重提高:模型可能不只學到想要的畫風,也把參考圖的主體與構圖一起複製
當權重降低:構圖干擾減少,畫風又可能變得太淡。
Step 3:我們真正想控制的是兩件不同的事
| 控制目標 | 想保留的資訊 | 不希望一起帶入的資訊 |
|---|---|---|
| Style 畫風 | 色彩、筆觸、光線、材質、渲染語言 | 原圖人物、物件位置與內容 |
| Composition 佈局 | 主體位置、畫面比例、視角、留白與大形狀 | 原圖色彩、材質與藝術風格 |
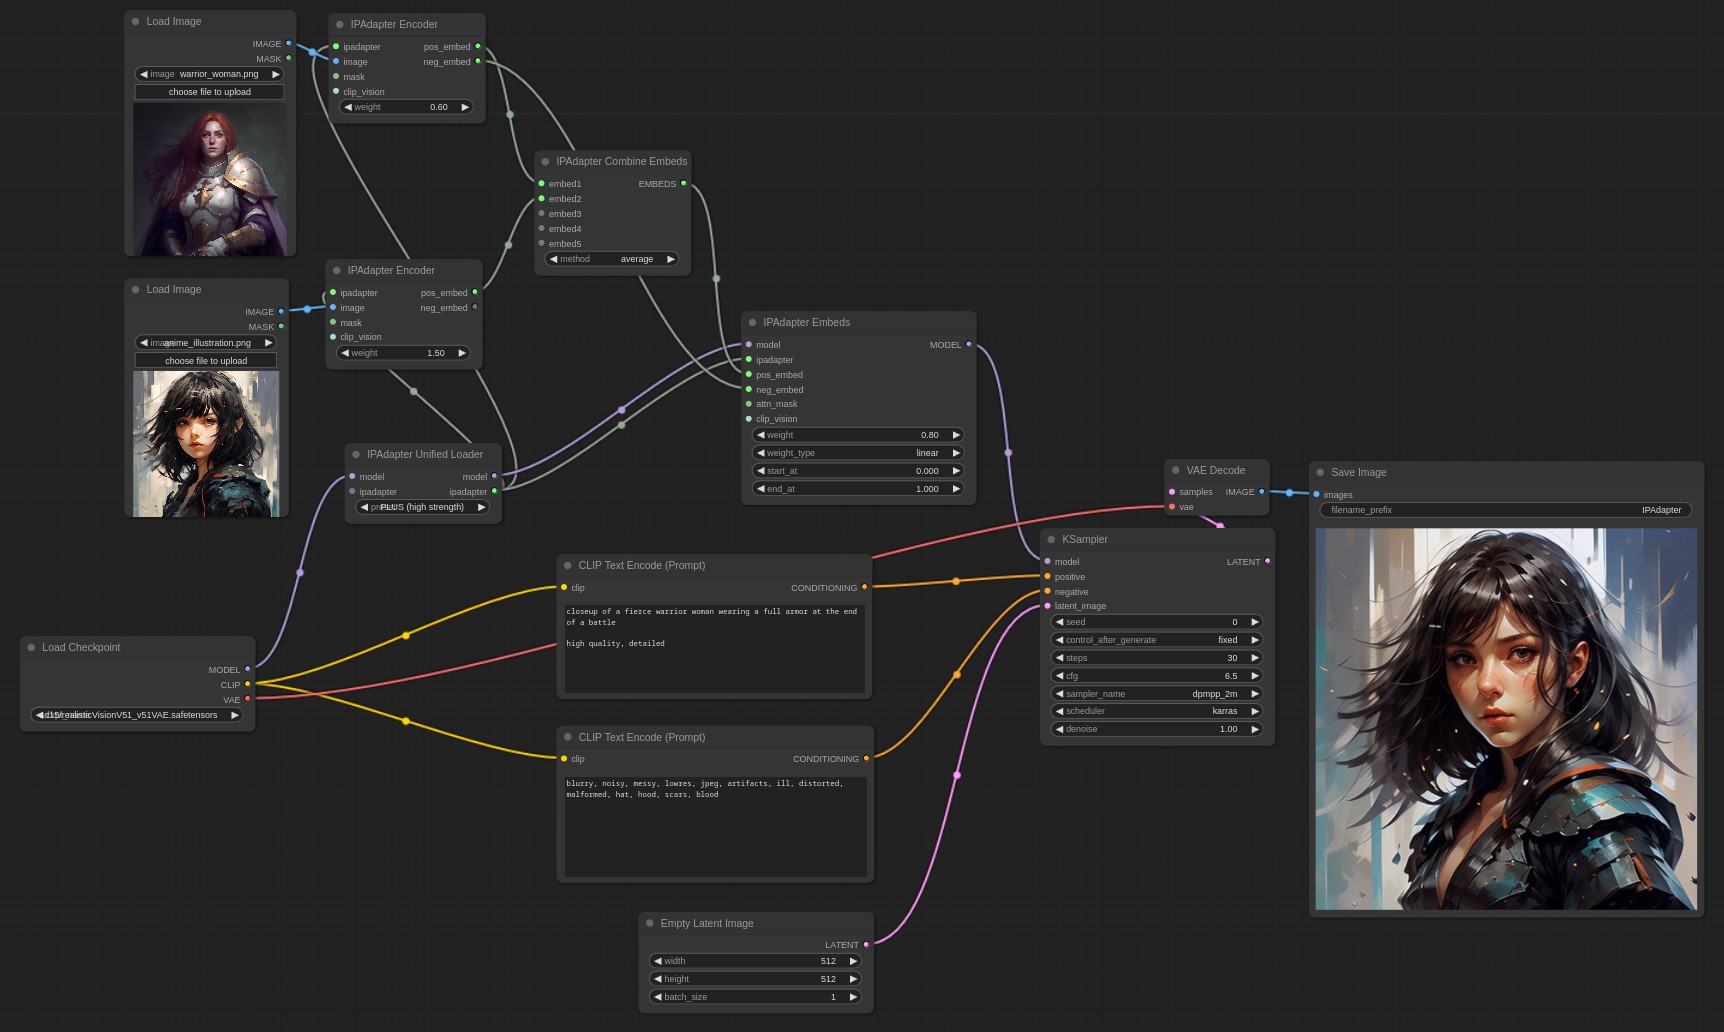
因此理想工作流應該允許兩張參考圖:
Style 圖:只負責視覺語言
Composition 圖:只負責畫面骨架,再由 Prompt 決定最後要生成的主題。
Step 4:IP-Adapter 是什麼?
IP-Adapter 的核心概念,是先用 CLIP Vision 將參考圖片 轉成視覺特徵,再透過額外的 Image Prompt Adapter 將影像條件加入擴散模型。
文字 Prompt ─→ Text Encoder ───────────┐
                                       ├→ SDXL UNet → KSampler → 圖片
參考圖片 ─→ CLIP Vision → IP-Adapter ───┘
它不是把參考圖直接做 Img2Img,也不需要針對每張圖片訓練 LoRA。
可以理解成: 臨時載入一張圖的視覺提示 ,但實際效果仍會受到模型、節點類型、權重與 Prompt 影響。
Step 5:Style & Composition 如何近似分離?
IPAdapter Style & Composition SDXL 不是先用 AI 辨識「這是風格、那是構圖」,而是利用 SDXL UNet 不同層對視覺特徵的反應差異
將 Style 與 Composition 的權重套用到不同區塊。
這也是此功能限定 SDXL 的原因:它依賴特定架構與層分工,不是所有 Stable Diffusion 或新型圖片模型都能直接共用。
Style Reference ──────→ 偏向畫風相關層 ─┐
                                          ├→ 修改後的 SDXL MODEL
Composition Reference → 偏向佈局相關層 ─┘
因此標題中的「分離」是實務上的可調式分工,不代表畫風與構圖可以百分之百完全解耦。
Step 6:IP-Adapter、ControlNet、LoRA 怎麼選?
| 技術 | 最擅長的控制 | 是否需要訓練 | 常見限制 |
|---|---|---|---|
| IP-Adapter | 圖片語意、畫風、主體與大構圖 | 否 | 不是像素級複製,特徵可能互相滲漏 |
| ControlNet | Pose、Depth、Canny、Lineart 等結構 | 否 | 需要合適的條件圖與對應模型 |
| LoRA | 固定人物、商品、概念或長期畫風 | 通常需要 | 訓練成本、資料品質與過度擬合 |
| Img2Img | 沿用原圖整體像素與結構 | 否 | Denoise 高低直接影響保留程度 |
「小結」:
| IP-Adapter | 適合想快速借用一張圖的視覺風格 |
| ControlNet | 適合需要關節或線條精準對齊、物件姿勢 |
| LoRA | 需要長期穩定重複某個角色或品牌 |
Step 7:本篇環境 - 對應規格
| 項目 | 本篇示例 |
|---|---|
| GPU | NVIDIA GeForce RTX 5070(12 GB VRAM) |
| CPU | Intel(R) Core(TM) i7-8700 CPU @ 3.20GHz,3192 Mhz,6 個核心,12 個邏輯處理器 |
| RAM | 48 GB |
| OS | Microsoft Windows 10 專業版 |
為了讓測試容易比較,第三部分會固定 Checkpoint、Prompt、Seed、Sampler 與輸出尺寸,只改動 IP-Adapter 參數。
第二部分:IP-Adapter ComfyUI工作流
Step 1:先備份目前可執行的 ComfyUI 環境
IP-Adapter Plus 是自訂節點,而且原作者已將專案調整為 maintenance-only。更新前建議保存:
- ComfyUI 目前版本或 Git Commit
- custom_nodes 清單與版本
- 已成功執行的 Workflow JSON
- models/ipadapter 與 models/clip_vision 檔名
- Python、PyTorch、CUDA 與顯示卡驅動資訊
如果更新後工作流壞掉,這些資料能協助判斷是模型缺失、節點改名,還是 ComfyUI API 相容性問題。
Step 2:完整工作流 - 大綱
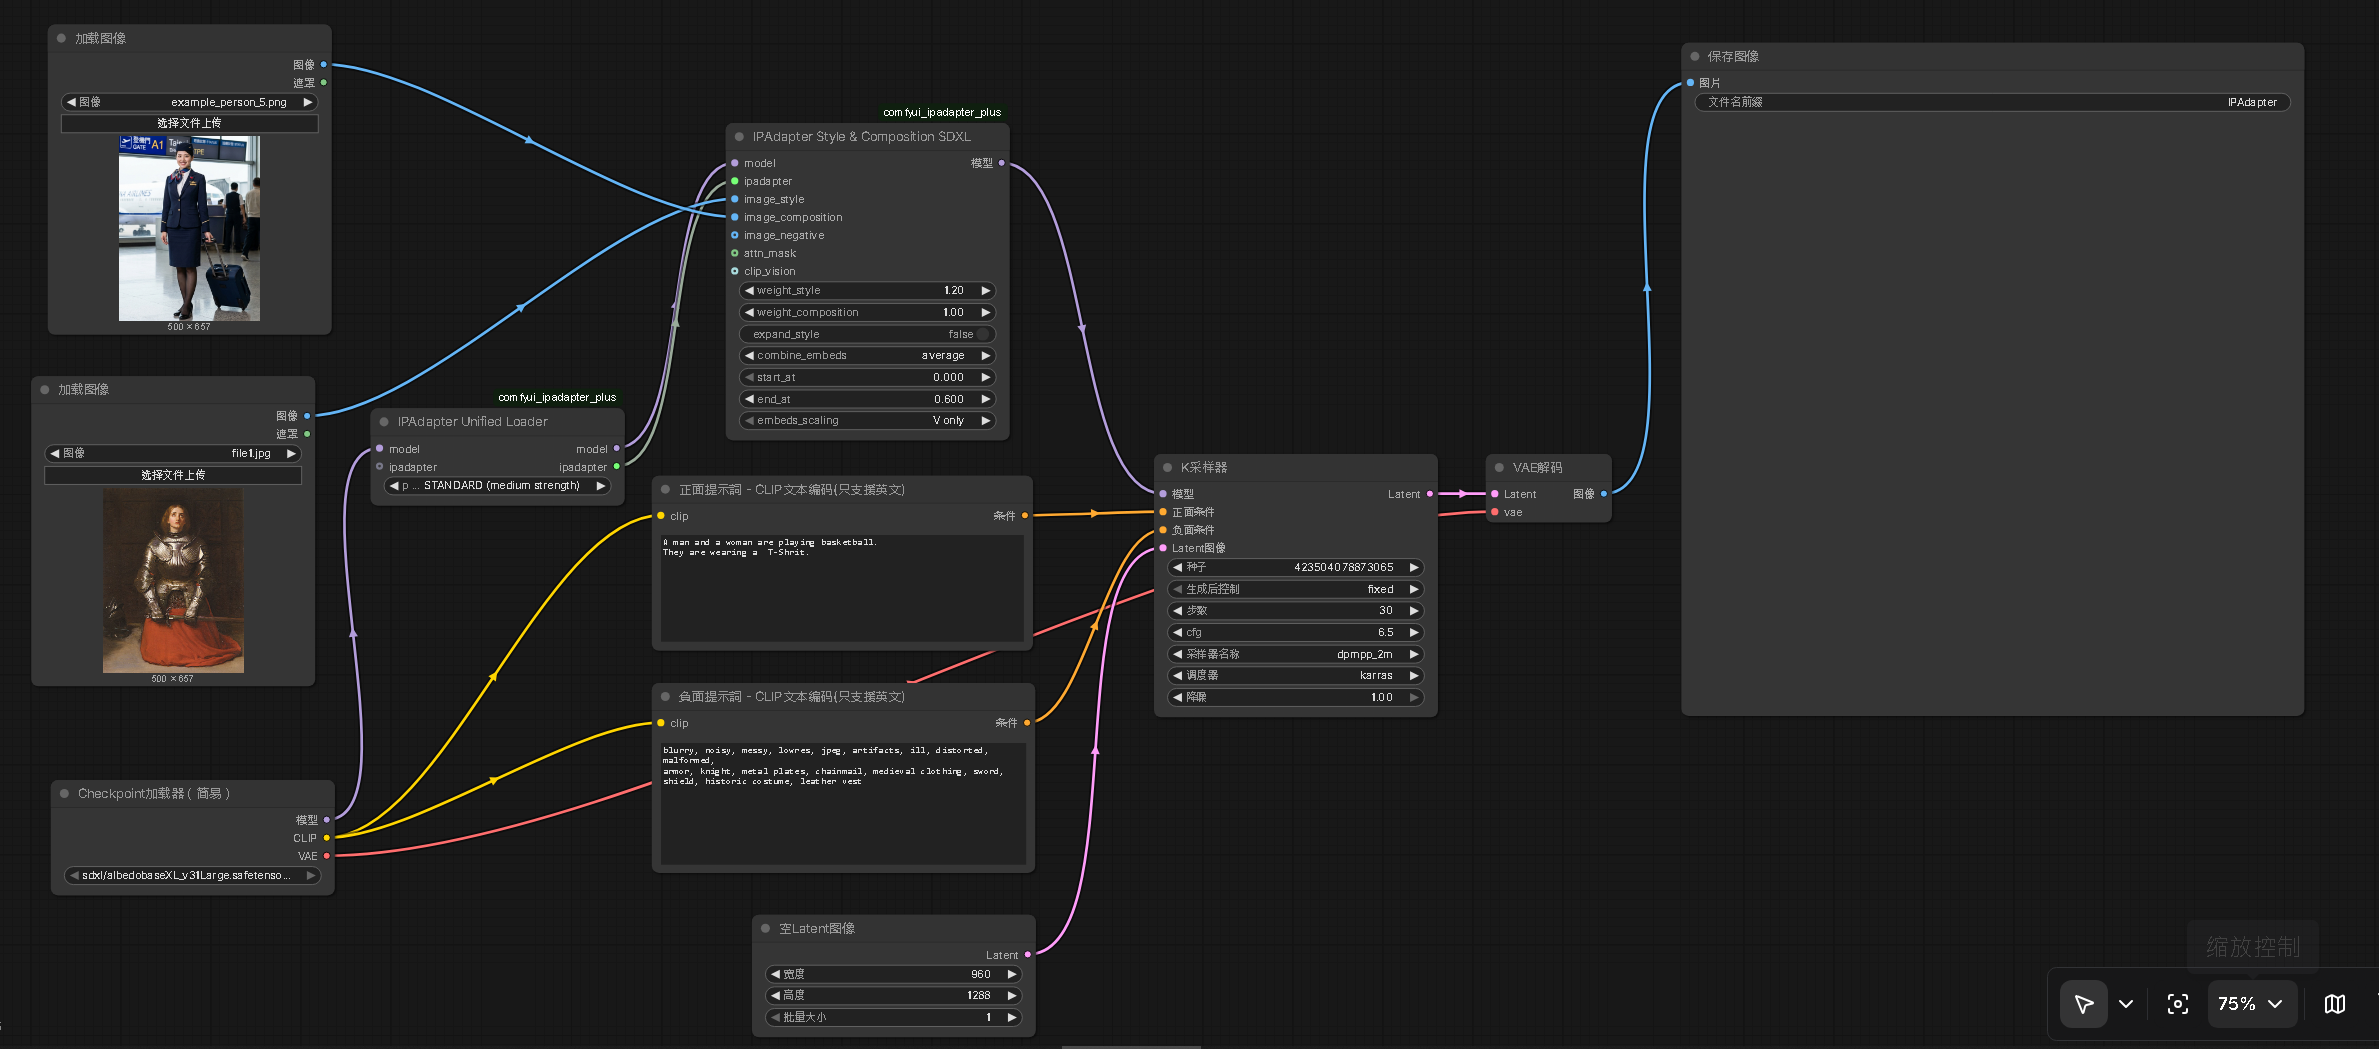
主要的節點結構,與官方工作流.json 一致,但關於風格參數有做過調整,目的是不能參考圖影響過大
調整的說明會在 第三部分補充,模型調整後完整的工作流如圖
Step 3:下載安裝 ComfyUI_IPAdapter_plus
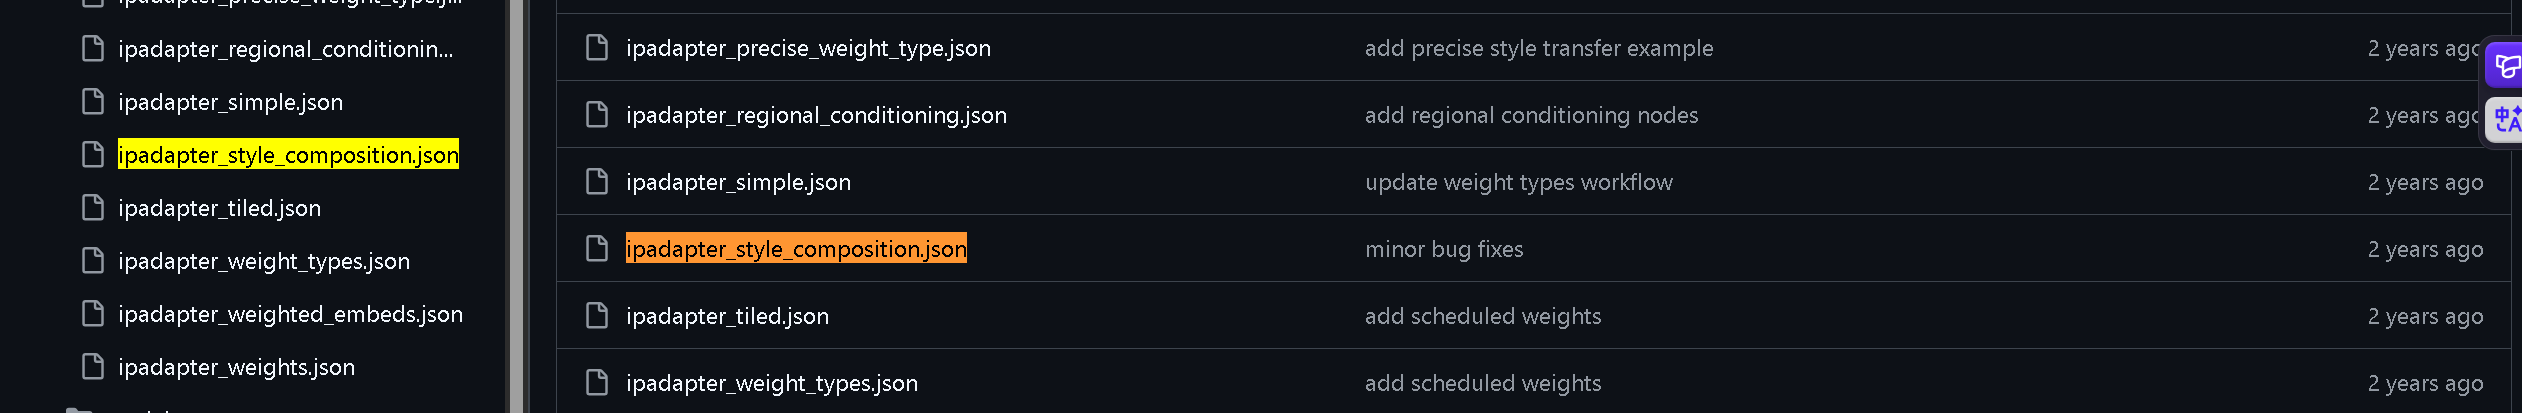
進入自訂節點, 下載 ComfyUI工作流
並且搜尋以下關鍵字:
ipadapter_style_composition.json
進行下載 -> 匯入到 ComfyUI
Step 4:補齊所需模型
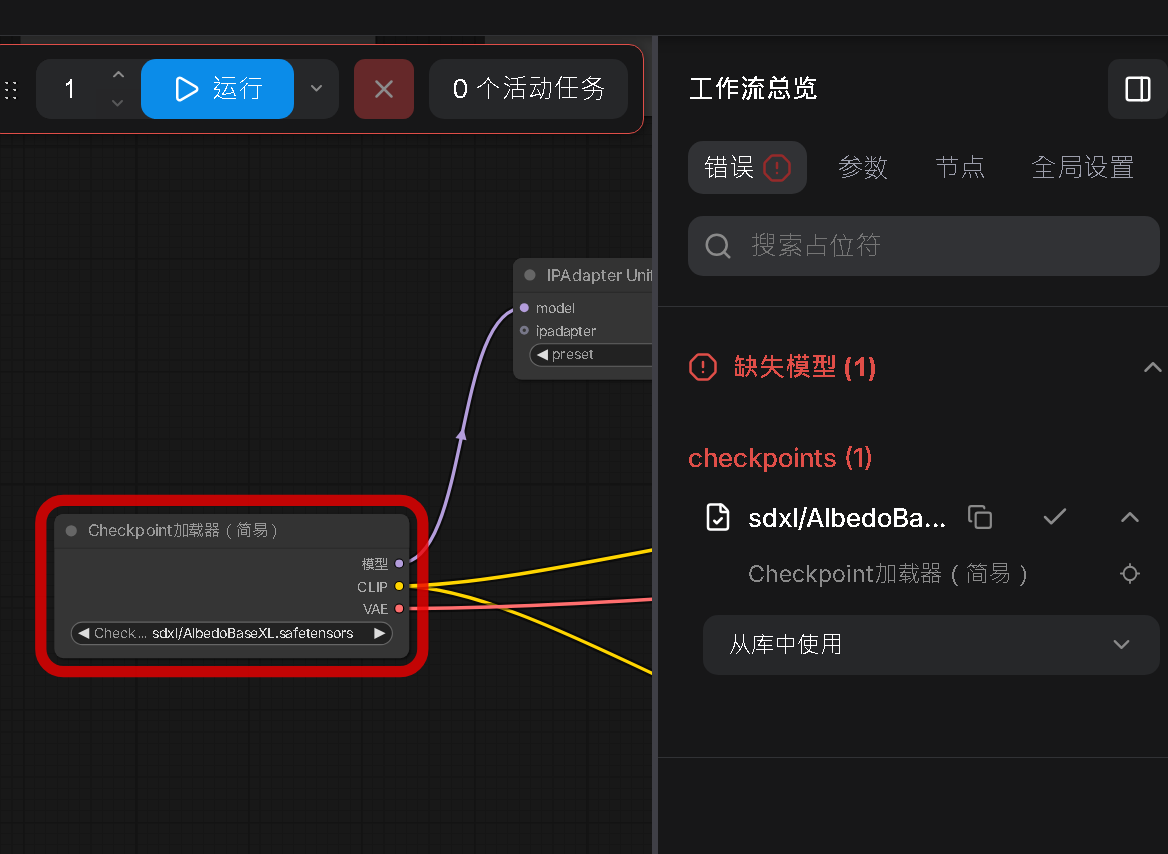
本篇核心節點需支援 SDXL,因此匯入工作流後,需要開始下載所有相關模型
ComfyUI/
└─ models/
   └─ checkpoints/
      └─ albedobaseXL_v31Large.safetensors
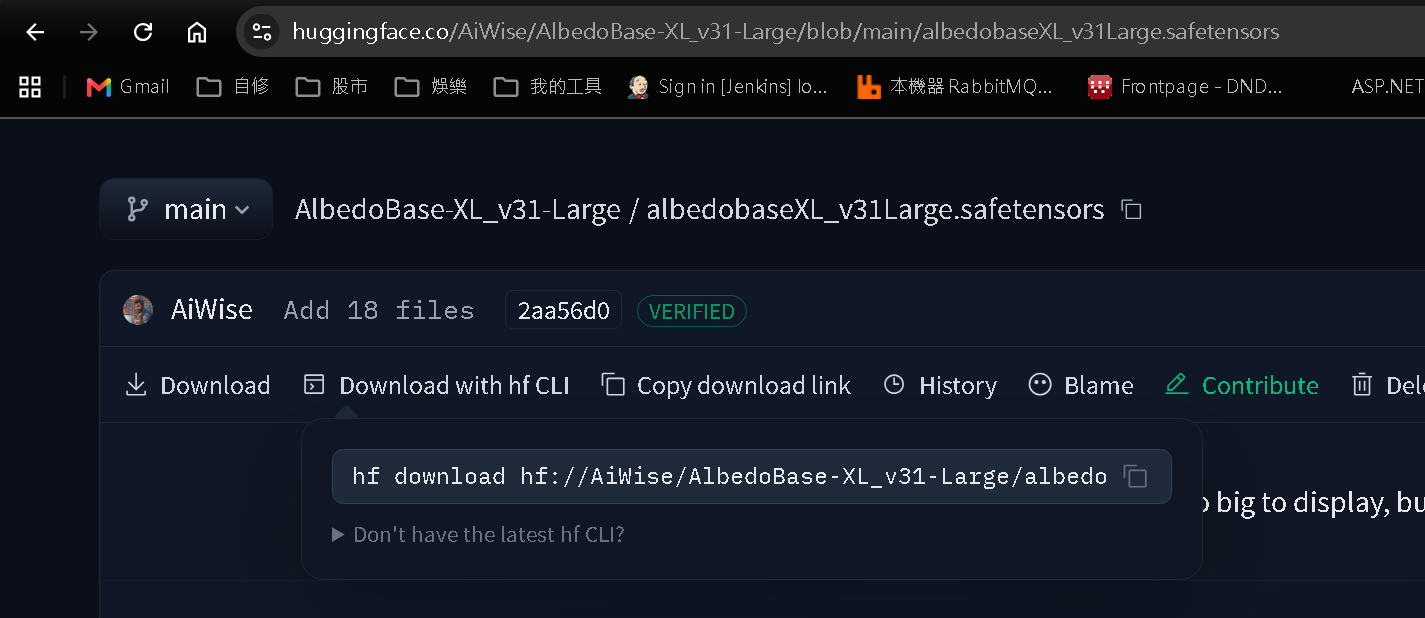
下載位置 albedobaseXL_v31Large.safetensors
Step 5:補齊所需模型 - 下載SDXL並放入
如圖,可以複製 hf 語法,並且補上 –local-dir 參數,放到自己本機存放模型的位置(這邊舉例說明)
hf download hf://AiWise/AlbedoBase-XL_v31-Large/albedobaseXL_v31Large.safetensors --local-dir H:\
6.94GB 需耗費一些時間
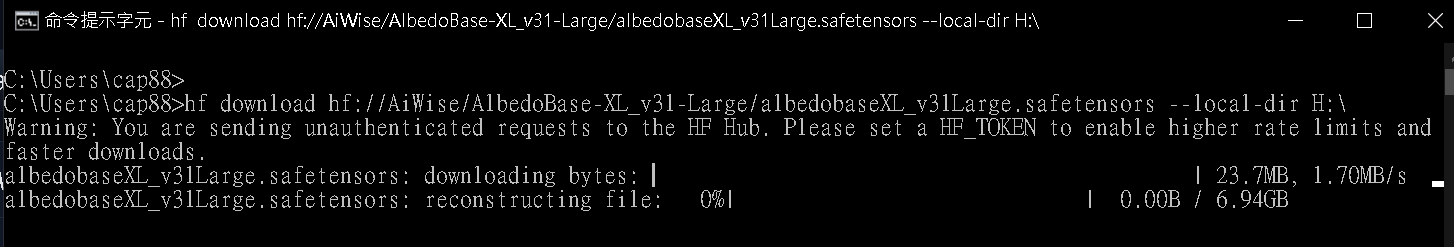
完成後,放在自己 ComfyUI Model 對應的目錄
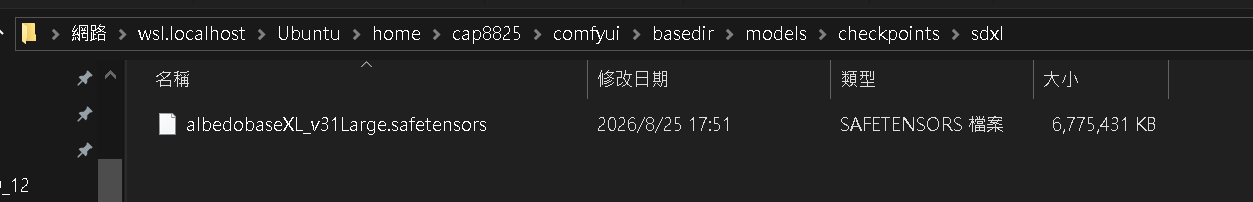
Step 6:補齊所需模型 - 下載 CLIP Vision 模型
SDXL 存放正確後,接著還會出現 CLIP 模型需安裝的提示
ComfyUI/
└─ models/
   └─ clip_vision/
      └─ CLIP-ViT-bigG-14-laion2B-39B-b160k.safetensors
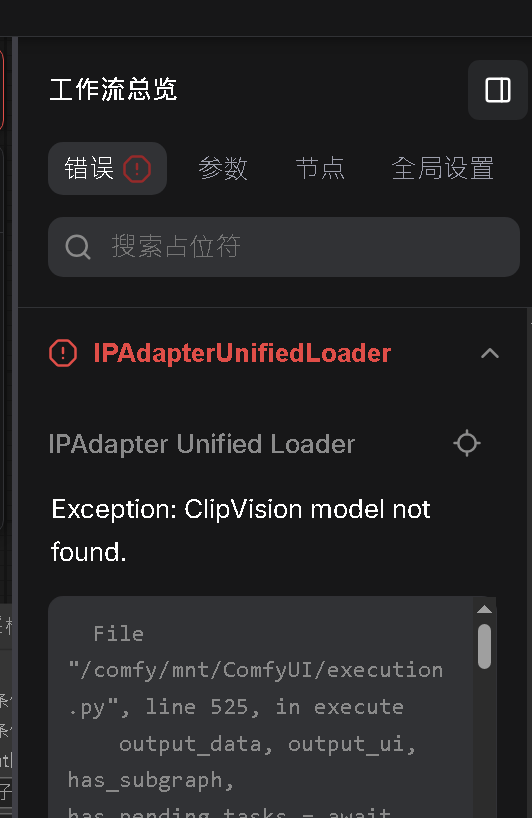
回到官方的IPAdapter_plus,下方會有補充需下載的模型
並且下載時檔案名稱為 model ,因此下載後要重新命名
Step 7:補齊所需模型 - 下載 IP-Adapter Plus 模型
我們使用 Plus 工作流,因此下載對應模型,但此模型是專屬於 IP-Adapter
ComfyUI/
└─ models/
   └─ ipadapter/
      └─ ip-adapter-plus_sdxl_vit-h.safetensors
因此官方也有說明, 若資料夾不存在要自己建立
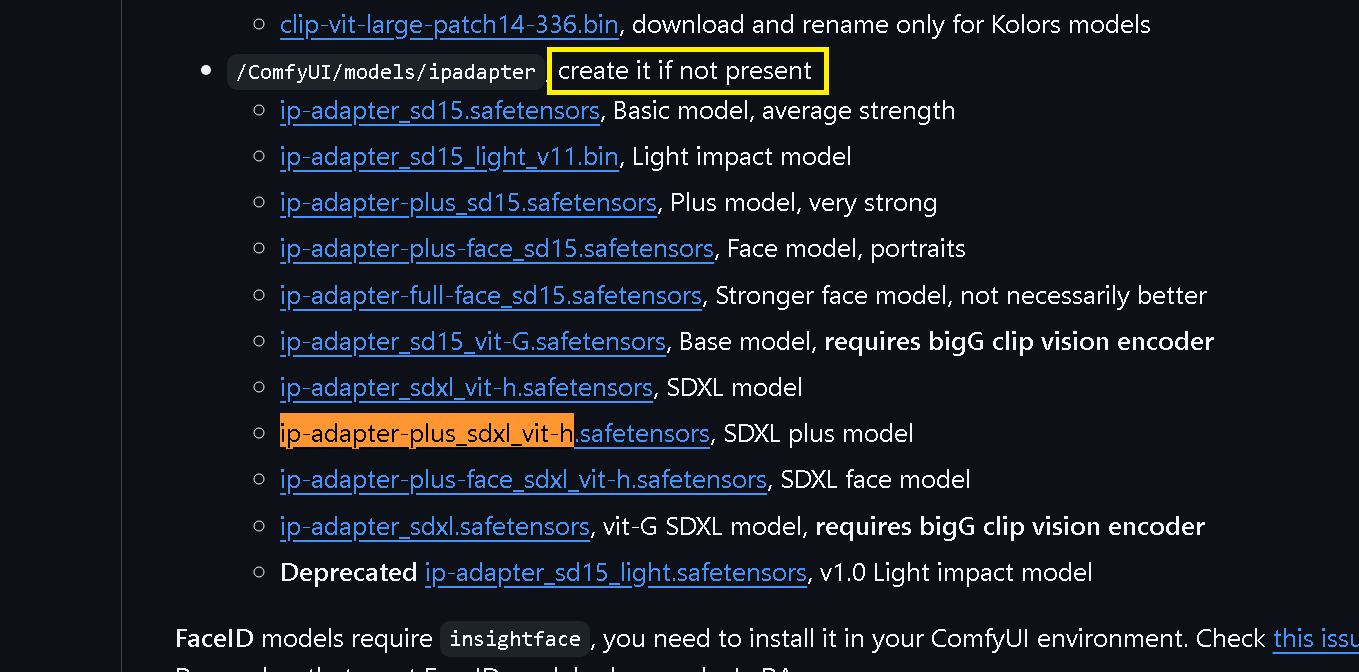
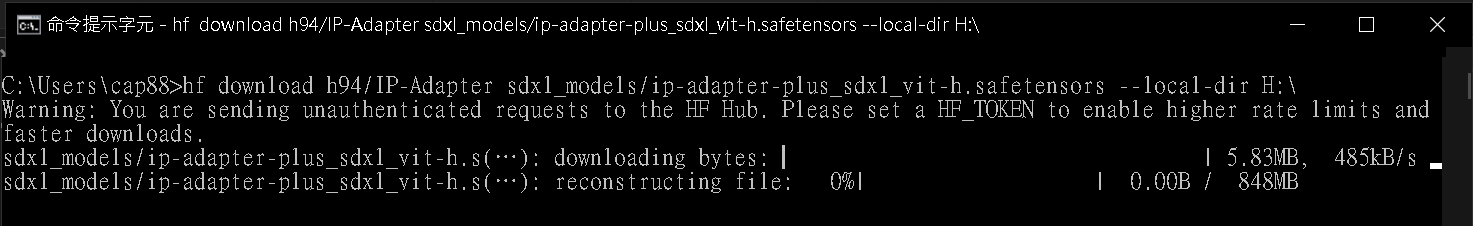
回到官方的IPAdapter_plus說明頁,然後一樣可以透過 hf 指令下載,然後放進對應目錄
Step 8:補齊所需模型 - 仍然會錯誤
上述 3 個最基本的模型下載後,仍然會出現錯誤,實際上當前只有一種解決方案:全部模型下載
Step 9:錯誤原因 - Issue 排查結果
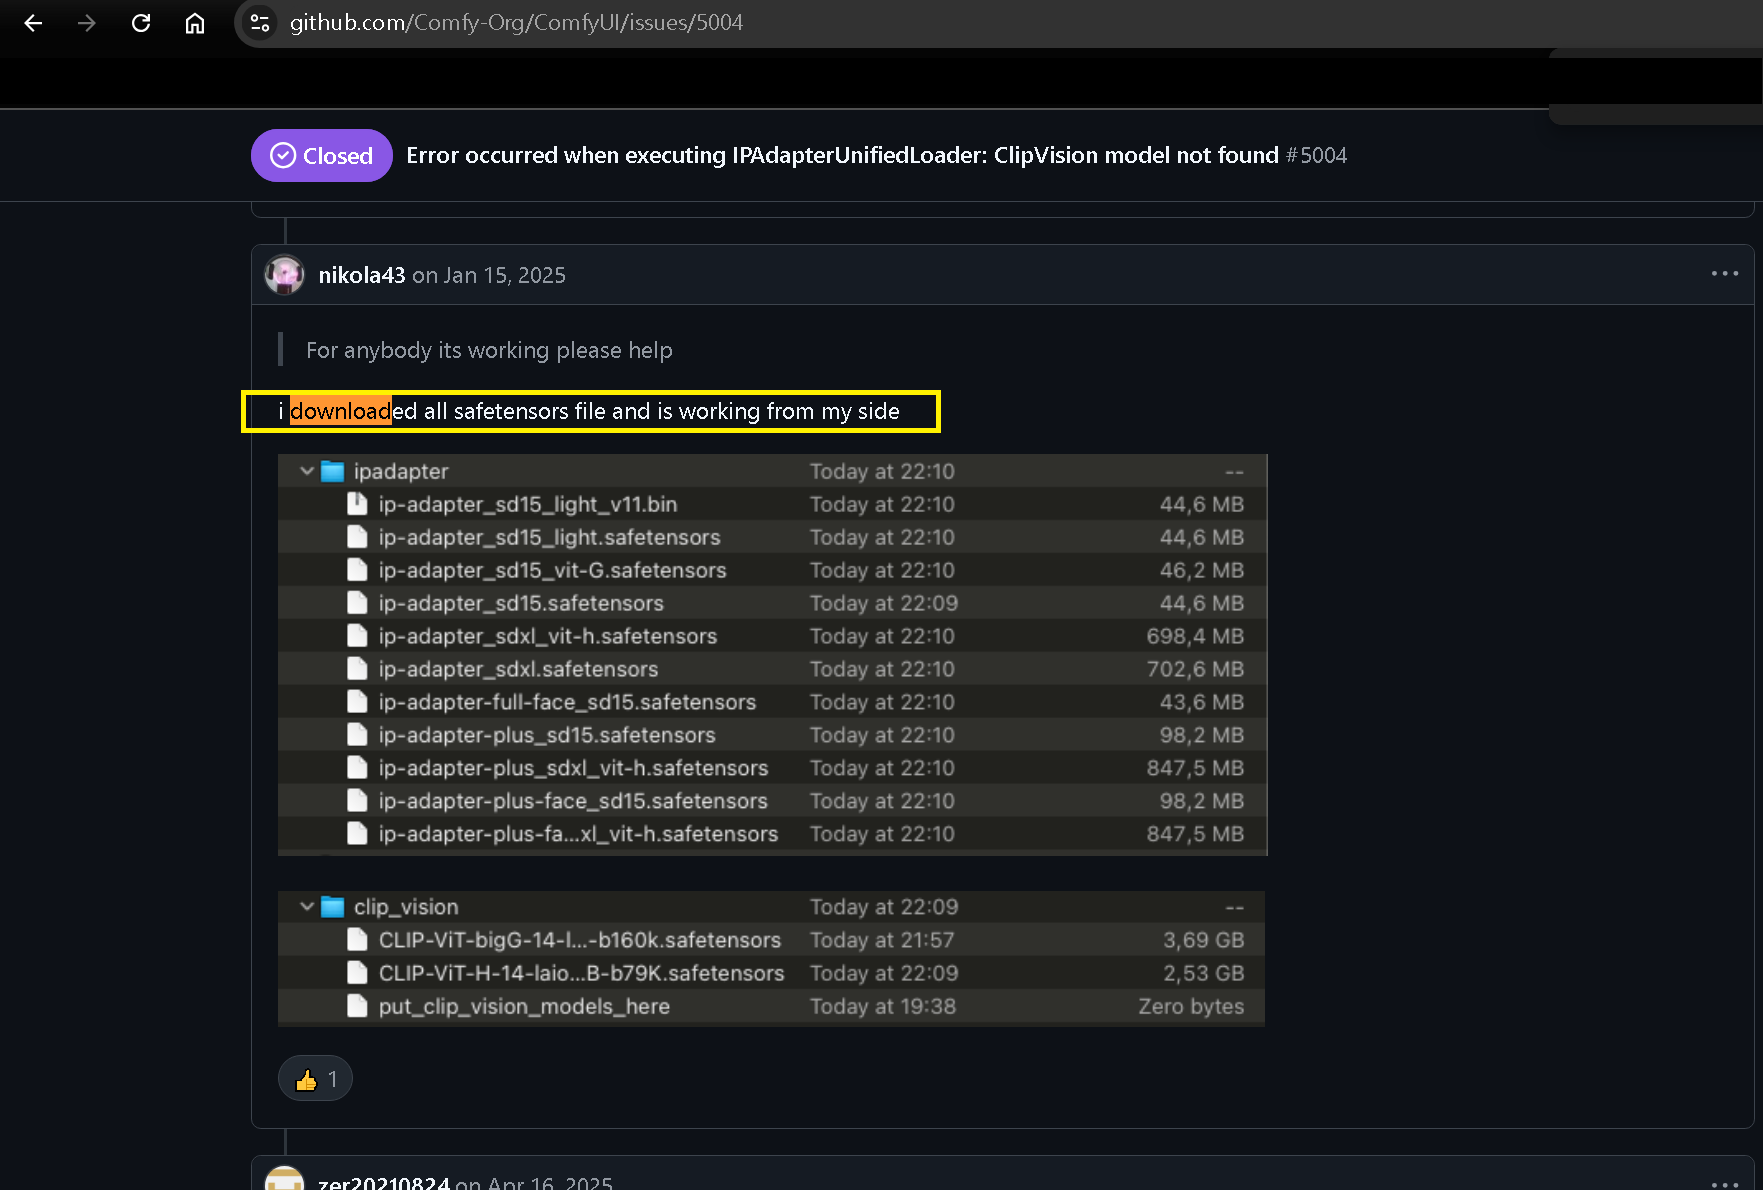
這其實在 Github 中的 Issiue 中有 使用者回報與討論 ,討論連結
用戶在 Issue 反饋的解法:
原因:官方的工作流在檢查模型時,會需要全部存在,才能跳過這個錯誤
附上所有模型 hf 下載(便於複製貼上,不用一個個去找):
※ SDXL 的 3 檔案下載後要立刻改名,避免被後續下載的檔案覆蓋刪除(除非目錄不同,或額外設定)。
SDXL 模型:
hf download hf://AiWise/AlbedoBase-XL_v31-Large/albedobaseXL_v31Large.safetensors --local-dir H:\
hf download hf://casque/realisticVisionV51_v51VAE/realisticVisionV51_v51VAE.safetensors --local-dir H:\
hf download hf://Eata/SD1.5/020.realisticVisionV51_v51VAE.safetensors --local-dir H:\

CLip_Vision 模型:
hf download h94/IP-Adapter models/image_encoder/model.safetensors --local-dir H:\
hf download h94/IP-Adapter sdxl_models/image_encoder/model.safetensors --local-dir H:\
hf download Kwai-Kolors/Kolors-IP-Adapter-Plus image_encoder/pytorch_model.bin --local-dir H:\

IP-Adapter Plus 模型:
hf download h94/IP-Adapter models/ip-adapter_sd15.safetensors --local-dir H:\
hf download h94/IP-Adapter models/ip-adapter_sd15_light_v11.bin --local-dir H:\
hf download h94/IP-Adapter models/ip-adapter-plus-face_sd15.safetensors --local-dir H:\
hf download h94/IP-Adapter models/ip-adapter-full-face_sd15.safetensors --local-dir H:\
hf download h94/IP-Adapter models/ip-adapter_sd15_vit-G.safetensors --local-dir H:\
hf download h94/IP-Adapter sdxl_models/ip-adapter_sdxl_vit-h.safetensors --local-dir H:\
hf download h94/IP-Adapter sdxl_models/ip-adapter-plus_sdxl_vit-h.safetensors --local-dir H:\
hf download h94/IP-Adapter sdxl_models/ip-adapter-plus-face_sdxl_vit-h.safetensors --local-dir H:\
hf download h94/IP-Adapter sdxl_models/ip-adapter_sdxl.safetensors --local-dir H:\
hf download h94/IP-Adapter models/ip-adapter_sd15_light.safetensors --local-dir H:\
Step 10:參數說明
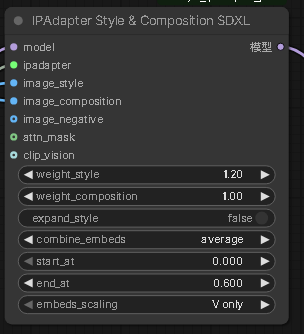
核心節點是 IPAdapter Style & Composition SDXL ,關鍵在調整風格參考圖的影響力
以下是參數說明:
| 參數 | 說明 |
|---|---|
| weight_style | 控制「風格參考圖」的影響權重強度。數值越高風格越強烈;若發現元素污染可適度調低。 |
| weight_composition | 控制「構圖參考圖」的影響權重強度。數值越高越嚴格貼合參考圖的空間排版與物體佈局。 |
| expand_style | 風格特徵擴展模式(true/false)。開啟時會將風格特徵向量擴展並分配到更多層級,強化風格表現。 |
| combine_embeds | 當輸入多張參考圖時的特徵融合計算方式(如 average、concat 等)。 |
| start_at | IP-Adapter 開始介入去噪流程的步數比例(0.000 代表從第一步開始注入)。 |
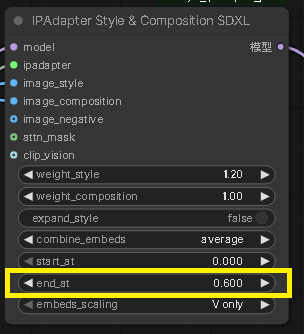
| end_at | IP-Adapter 停止介入去噪流程的步數比例(如 0.600 代表在去噪進行到 60% 時停止注入,後續交由 Prompt 與模型收斂細節以避免內容污染)。 |
| embeds_scaling | 特徵向量縮放與注入策略(如 V only、K+V 等),決定特徵如何映射到交叉注意力層(Cross-Attention)中。 |
實際使用,需依照自己需求調整參數
第三部分:驗證成果 & 優化
Step 1:驗證結果 - 首次測試
參考圖與構圖建議尺寸要一致,IP-Adapter 只支援 英文 Prompt
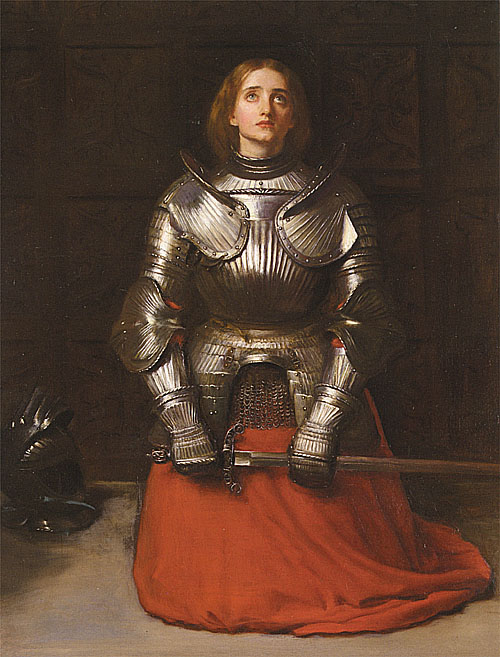
參考圖:年份:1865年 | 畫家:米雷 | 作品名稱:聖女貞德
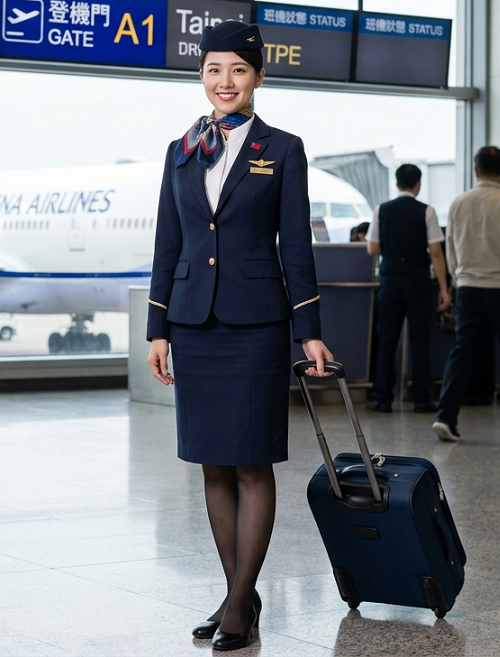
構圖:一名穿著制服的空服人員
正面 Prompt:A man and a woman are playing basketball. They are wearing a T-Shrit.
負面 Prompt:blurry, noisy, messy, lowres, jpeg, artifacts, ill, distorted, malformed
參考圖(年份:1865年 | 畫家:米雷 | 作品名稱:聖女貞德 ):
構圖(一名穿著制服的空服人員):
Step 2:驗證結果 - 首次執行結果
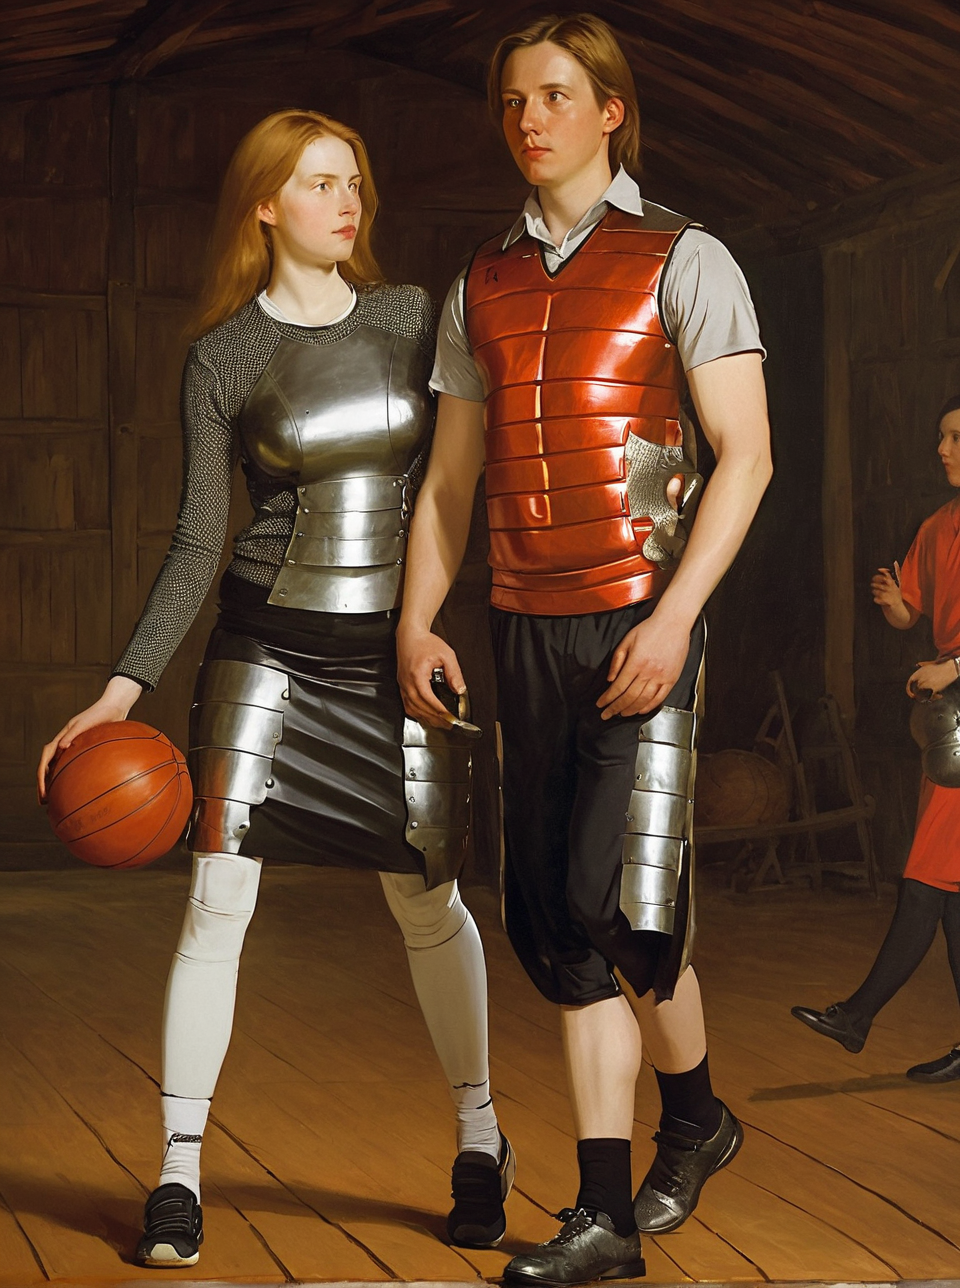
首次輸出後,會發現打籃球的人會穿著中世紀鎧甲,這是因為參考圖的影響力過大
這時需要進行 參數的優化
Step 3:驗證結果 - 優化參數
我們已經確定參考圖出現的元素有盔甲、騎士、金屬等等,因此負面提示詞追加,避免再次出現
負面原始的 Prompt:blurry, noisy, messy, lowres, jpeg, artifacts, ill, distorted, malformed
負面追加的 Prompt:armor, knight, metal plates, chainmail, medieval clothing, sword, shield, historic costume, leather vest
調整 end_at(結束步數比例):將 end_at 設為 0.6 ~ 0.7(預設為 1.0) 原因:
擴散模型在前 30%~60% 的步數決定整體的色彩、氛圍與大致風格,而在後 40% 的步數負責收斂具體的衣服細節與物件結構。
提早結束 IP-Adapter 的注入,能讓模型在生成後期完全遵從 Prompt 去畫出純棉的 T-shirt,而不是金屬盔甲。
Step 4:驗證結果 - 優化後執行結果
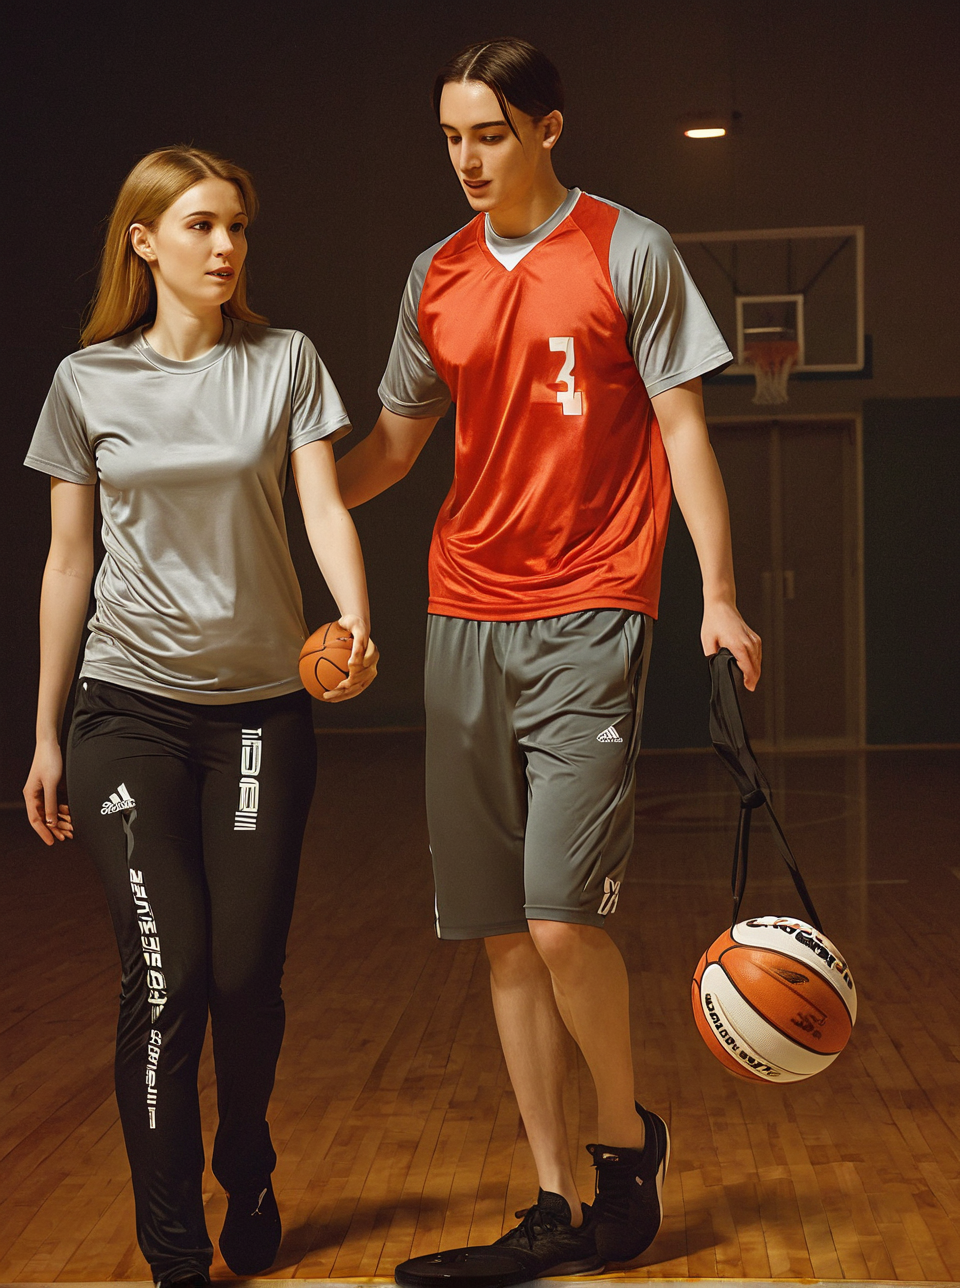
再次執行後,生成的圖片保留了原構圖的女性(臉型、體態、姿勢),然後融入了聖女貞德的畫作風格
※AI生成圖片錯誤的細節可以再持續進行調整
第四部分:分析、遺留問題探討
Step 1:「分離」不是完全解耦
Style Reference 仍然可能影響構圖,Composition Reference 也可能帶入顏色與內容。原因包括:
- CLIP Vision Embedding 本身同時包含語意、風格與構圖
- SDXL 不同 UNet Layer 的功能不是絕對分離
- 參考圖內容太強,模型容易將它當成主體提示
- Prompt、Checkpoint 與兩張參考圖彼此衝突
正確期待是「讓兩種影響可以分別調整」,而不是做到圖像編輯軟體般的精準圖層拆解。
Step 2:Composition 不等於 ControlNet
| 需求 | IP-Adapter Composition | ControlNet |
|---|---|---|
| 主體大致在左側 | 適合 | 適合 |
| 沿用鏡頭與留白節奏 | 適合 | Depth 可協助 |
| 人物關節完全一致 | 不穩定 | Pose 更合適 |
| 商品輪廓精準一致 | 不穩定 | Canny / Lineart 更合適 |
| 空間前後關係 | 大致控制 | Depth 更明確 |
如果 Composition 權重加到很高仍無法對齊,不應無限提高;改用 ControlNet,讓 IP-Adapter 專注 Style,通常更容易控制。
Step 3:高權重造成 Prompt 失效
當 Style 與 Composition 都使用高權重,Image Prompt 可能壓過文字:
症狀:
- 明明要求香水瓶,結果仍出現參考圖的汽車
- Prompt 指定新配色,但結果完全沿用 Style 圖
- Negative Prompt 排除 Logo,仍產生類似標誌
- 畫面過度對比、飽和或細節破碎
優先降低 IP-Adapter 權重、簡化參考圖及加強具體 Prompt。不要只提高 CFG,因為那可能讓兩套強條件進一步衝突。
Step 4:人物一致性不是此工作流的主要能力
Style & Composition 節點 擅長畫風和大佈局 ,不保證人物五官、商品 Logo 或文字逐像素一致。
若目標是固定人物,可研究 FaceID、InstantID 或人物專用 LoRA;若目標是商品識別,可能需要更嚴格的遮罩、ControlNet、Reference-only 方法或後製合成。
每多加入一個控制模組,都應重新平衡權重與顯存,不要把所有控制同時設為最大值。
Step 5:版權、肖像與畫風參考
技術上能讀取參考圖,不代表擁有使用權。商業使用前應確認:
- Style 與 Composition 參考圖的來源與授權
- 圖片中人物的肖像權與隱私
- 商標、Logo、產品包裝與受保護角色
- SDXL Checkpoint、IP-Adapter 與其他模型的 License
- 客戶素材是否允許上傳、處理與衍生
- 生成結果是否與原作過度相似
「只取畫風」不是自動免除著作權或合約責任。高風險商業用途應保留素材來源與生成紀錄,必要時諮詢法律專業人士。